Multi-turn Agent Eval 2 - 써 둔 대화에서 LLM 사용자로 옮겨 왔습니다
1편에서 여러 턴 평가를 두 가지로 나눴습니다. 다음 사용자 말을 미리 써 두느냐, LLM 이 agent 의 답을 보고 쓰느냐입니다. 2023년 이후 나온 방법 열세 가지를 그 둘로 나눠 시대순으로 놓으면 이렇습니다.
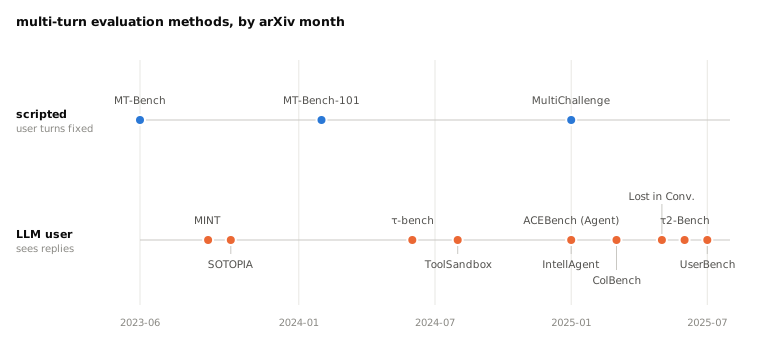
써 둔 대화는 세 개뿐이고, 2024년부터는 LLM 사용자가 대부분입니다. 사용자를 LLM 에게 맡기는 방법이 자리 잡으면서 agent 가 실제로 주고받는 능력을 재는 쪽으로 옮겨 왔습니다.
1. 한 줄씩
  나온 때   이름            사용자 말   다음 턴을 누가                무엇을 채점
  2023-06   MT-Bench        써 둔       써 둔 2턴째 질문              GPT-4 가 1~10점 · 둘 비교
  2023-09   MINT            LLM         GPT-4 가 피드백 주는 사용자   턴 예산 안에 성공했나
  2023-10   SOTOPIA         LLM         역할극 상대(agent · 사람)     7개 항목, 사람과 GPT-4 판정
  2024-02   MT-Bench-101    써 둔       써 둔 정답 기록               턴마다 GPT-4, 가장 낮은 턴
  2024-06   τ-bench         LLM         LLM 사용자                    끝 상태 · pass^k
  2024-08   ToolSandbox     LLM         LLM 사용자                    중간 단계와 끝 상태
  2025-01   ACEBench        둘 다       gpt-4o 사용자                 끝 상태 + 호출 과정
  2025-01   MultiChallenge  써 둔       써 둔 기록                    문제마다 yes / no 질문
  2025-01   IntellAgent     LLM         정책에서 만든 사용자 agent    정책을 지켰나
  2025-03   ColBench        LLM         LLM 협업자                    unit test · 화면 유사도
  2025-05   Lost in Conv.   LLM         조각을 하나씩 주는 사용자     같은 과제의 한 턴 점수와 비교
  2025-06   τ2-Bench        LLM         LLM 사용자 (tool 도 씀)       끝 상태 등 5가지 · pass^k
  2025-07   UserBench       LLM         선호를 흘리는 사용자          의도를 모두 맞췄나
ACEBench 는 묶음에 따라 다릅니다. 정해진 문항(Normal)은 써 둔 대화이고, Agent 문항만 LLM 사용자입니다. 연대표에는 Agent 문항으로 넣었습니다.
2. 써 둔 대화 — agent 가 몇 번 답하나가 다릅니다
  MT-Bench        1턴과 2턴에 모두 답한다. 2턴 질문은 1턴 답과 상관없이 같다
  MT-Bench-101    턴마다 답하되, 앞 턴들은 미리 써 둔 정답으로 채운다 (golden context)
  MultiChallenge  앞 턴들을 다른 모델이 쓰고 사람이 고쳤다. 마지막 턴에만 답한다
MT-Bench-101 은 이유를 이렇게 적었습니다. 모델이 앞에서 한 번 삐끗하면 뒤의 대화가 어색해져서 공정하게 비교할 수 없다는 겁니다. 대신 자기 실수에서 회복하는 능력은 보지 못합니다. 3편이 MultiChallenge 를 자세히 봅니다.
3. LLM 사용자 — 사용자를 어떻게 흉내 내나가 다릅니다
일을 끝내는지 보는 쪽. τ-bench, ToolSandbox, ACEBench, τ2-Bench 는 agent 가 tool 로 예약을 바꾸고 설정을 고치게 하고, 끝난 뒤의 상태를 봅니다. ToolSandbox 는 끝만이 아니라 반드시 거쳐야 할 단계(milestone)와 밟으면 안 되는 단계(minefield)도 봅니다. 4편이 τ2-Bench 를 자세히 봅니다.
IntellAgent 는 끝 상태 대신 정책을 봅니다. 회사 정책 문서에서 시나리오를 자동으로 만들고, 대화가 끝나면 판정 LLM 이 대화를 읽고 어떤 정책을 시험했고 어떤 정책을 어겼는지 적습니다. 공개 벤치마크가 없는 분야에도 쓸 수 있습니다.
대화로 알아내는지 보는 쪽. 사용자가 처음부터 다 말하지 않습니다.
  MINT            틀리면 GPT-4 가 선생님처럼 방향만 알려준다
  Lost in Conv.   과제를 조각내서 한 턴에 하나씩 준다
  UserBench       목표를 흐릿하게 시작해 선호를 은근히 흘린다
Lost in Conversation 의 방법이 가장 깔끔합니다. 같은 과제를 한 번에 다 주는 것과 조각내 여러 턴에 주는 것을 비교하니, 여러 턴 때문에 잃는 몫이 바로 나옵니다. 최신 모델들이 평균 39% 떨어졌습니다. 논문의 표현으로 "when LLMs take a wrong turn in a conversation, they get lost and do not recover" 입니다.
UserBench 는 사용자의 의도를 모두 맞춘 답이 평균 20% 였고, 가장 좋은 모델도 알아낸 선호가 전체의 30% 미만이었다고 적었습니다.
함께 만들거나 어울리는 쪽. ColBench 는 LLM 이 맡은 협업자와 주고받으며 백엔드 코드(unit test 로 채점)와 웹 화면(정답 화면과의 이미지 유사도로 채점)을 만듭니다. SOTOPIA 는 사회적 목표가 있는 역할극을 하고 목표 달성 등 7개 항목을 사람과 GPT-4 가 판정합니다.
4. Kimi K2 가 고른 셋
Kimi K2(2025년 7월)는 여러 턴 능력을 이 셋으로 쟀습니다.
  τ2-Bench        2025-06   LLM 사용자   tool 로 일을 끝내나       66.1
  ACEBench        2025-01   둘 다        tool 을 맞게 부르나       76.5
  MultiChallenge  2025-01   써 둔 대화   긴 대화를 놓치지 않나     54.1
LLM 사용자 쪽 둘과 써 둔 대화 하나입니다. 다만 ACEBench 76.5 는 Agent 문항만이 아니라 "overall on ACEBench English", 세 묶음을 합친 점수라 여러 턴만의 점수는 아닙니다.
출처
- 날짜는 arXiv 에 처음 올라온 달입니다. 각 방법이 무엇을 하는지는 초록과 본문에서, 숫자는 본문에서 옮겼습니다.
- Zheng 외 2023 · Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena.
arXiv:2306.05685. - Wang 외 2023 · MINT.
arXiv:2309.10691. - Zhou 외 2023 · SOTOPIA.
arXiv:2310.11667. - Bai 외 2024 · MT-Bench-101.
arXiv:2402.14762. - Yao 외 2024 · τ-bench.
arXiv:2406.12045. - Lu 외 2024 · ToolSandbox.
arXiv:2408.04682. - Chen 외 2025 · ACEBench.
arXiv:2501.12851. - Sirdeshmukh 외 2025 · MultiChallenge.
arXiv:2501.17399. - Levi · Kadar 2025 · IntellAgent.
arXiv:2501.11067. 정책 판정은 3.3절 Dialog Critique. - Zhou 외 2025 · SWEET-RL (ColBench).
arXiv:2503.15478. - Laban 외 2025 · LLMs Get Lost In Multi-Turn Conversation.
arXiv:2505.06120. - Barres 외 2025 · τ2-Bench.
arXiv:2506.07982. - Qian 외 2025 · UserBench.
arXiv:2507.22034. - Kimi Team 2025 · Kimi K2.
arXiv:2507.20534. 점수는 Table 3, ACEBench 가 전체 점수라는 건 평가 절입니다.