소개
AI 에이전트를 만드는 데 관심이 많은 개발자입니다.
에이전트가 안에서 어떻게 동작하는지 직접 뜯어보고, 돌려보고, 그 결과를 적습니다.
원칙은 하나입니다 — 직접 확인한 것만 씁니다. 확인하지 못한 것은 확인하지 못했다고 적습니다.
Claude Code에서 Codex를 서브에이전트로 쓰기
이 글에서 배우는 것: 다른 회사 모델에게 일을 넘기는 법. 실습 5분.
Claude Code로 코딩하다 막힐 때가 있습니다. 같은 모델에게 다시 물어도 같은 방식으로 틀립니다.
이럴 때 다른 모델에게 한 번 더 보게 하면 좋습니다. OpenAI의 Codex를 Claude Code 안에서 부를 수 있습니다.
1. 준비
Codex CLI가 필요합니다.
npm install -g @openai/codex
codex login
확인:
codex --version
# codex-cli 0.149.1
ChatGPT 계정(무료 포함)이나 OpenAI API 키가 있어야 하고, 사용량은 Codex 쪽 한도에서 차감됩니다.
2. 실습 — 직접 불러보기
서브에이전트로 감싸기 전에, Codex를 손으로 한 번 불러봅니다. 이게 되면 나머지는 포장일 뿐입니다.
버그가 있는 파일을 하나 만듭니다.
mkdir codexlab && cd codexlab
git init -q .                       # ← 이거 중요합니다. 이유는 아래에

cat > sum.py <<'EOF'
def average(nums):
    return sum(nums) / len(nums)
EOF
Codex에게 물어봅니다.
codex exec --sandbox read-only \
  "sum.py 의 average 함수는 어떤 입력에서 터지나? 한 문장으로 답하라." < /dev/null
실제 출력입니다. [관찰]
codex
`sum.py`의 구현만 확인해 실패 입력을 한 문장으로 요약하겠습니다.
exec
/bin/zsh -lc "sed -n '1,200p' sum.py"
 succeeded in 0ms:
def average(nums):
    return sum(nums) / len(nums)

codex
빈 리스트(또는 길이가 0인 입력)를 주면 0으로 나누어 `ZeroDivisionError`가 발생한다.
(문구는 실행할 때마다 조금씩 다릅니다. 요지가 같으면 정상입니다.)
Codex가 스스로 파일을 읽고 답했습니다. --sandbox read-only 라서 읽기만 하고 고치지는 않습니다 — 남의 모델에게 처음 일을 맡길 때 좋은 기본값입니다.
🚨 여기서 두 번 막힙니다
① git 저장소가 아니면 거부합니다.
Not inside a trusted directory and --skip-git-repo-check was not specified.
git init 을 먼저 하거나 --skip-git-repo-check 를 붙이세요. 실수로 작업물을 날리지 않게 하는 안전장치입니다.
② < /dev/null 을 빼면 멈춘 것처럼 보입니다. 프롬프트를 인자로 줘도 Codex는 stdin을 추가로 읽으려 합니다(Reading additional input from stdin...). 스크립트에서 부를 땐 꼭 막아주세요.
3. 서브에이전트로 만들기
방금 명령을 에이전트 파일 하나로 감싸면, 그때부터는 Claude에게 말로 시킬 수 있습니다.
.claude/agents/codex.md 를 만듭니다.
---
name: codex
description: 다른 모델의 시선이 필요할 때. 버그 원인 파악이나 코드 검토를 Codex에게 넘긴다.
tools: Bash
---

너는 Codex에게 일을 넘기는 얇은 전달자다.

사용자의 요청을 `codex exec` 명령 **한 번**으로 전달하고, 그 출력을 그대로 보고하라.

    codex exec --sandbox read-only "<요청>" < /dev/null

직접 파일을 읽거나 분석하지 마라. 전달만 하라.
Claude Code를 다시 띄우면 이렇게 쓸 수 있습니다.
codex 서브에이전트로 sum.py 를 검토해줘
핵심은 tools: Bash 한 줄입니다. 서브에이전트에게 Bash만 주면, 그 안에서 무엇을 부르든 상관없습니다. Codex든 다른 CLI든요.
직접 만들기 싫다면 OpenAI가 만든 플러그인이 있습니다.
/plugin marketplace add openai/codex-plugin-cc로 설치하면/codex:review같은 명령과codex-rescue서브에이전트가 딸려옵니다.
왜 굳이
같은 모델은 같은 곳에서 틀립니다. 제가 놓친 것을 제가 다시 볼 확률은 낮습니다. 다른 모델은 다른 곳에서 틀리니, 겹치지 않는 실수를 잡아줍니다.
그래서 구현보다 검토에 쓸 때 값어치가 큽니다.
확인 못 한 것
- 위 출력은 codex-cli 0.149.1 기준입니다. CLI 옵션은 자주 바뀝니다.
- 직접 만든 서브에이전트를 실제로 띄워보지는 못했습니다.
codex exec호출과 파일 형식(공식codex-rescue에이전트와 동일한 프론트매터)까지만 확인했습니다. - 요금과 사용량 한도는 확인하지 않았습니다. Codex 쪽 정책을 직접 보세요.
정리
codex exec한 줄이 전부입니다. 서브에이전트는 그걸 말로 부르기 좋게 감싼 것뿐입니다.git init먼저, 그리고< /dev/null. 이 둘에서 대부분 막힙니다.- 처음에는
--sandbox read-only로 시작하세요. - 구현보다 검토에 쓰는 게 낫습니다.
NP 는 어려운 문제가 아닙니다
다들 틀리게 말합니다
"그거 NP 라서 안 돼." 이 말은 보통 아래 셋 중 하나로 쓰입니다.
| 흔히 하는 말 | 사실 |
|---|---|
| "NP 니까 빨리 못 풀지" | NP 의 N 은 "못 한다"는 뜻이 아닙니다 |
| "NP-hard 는 NP-complete 보다 좀 약한 거지" | 거꾸로입니다. NP-hard 쪽이 훨씬 넓습니다 |
| "NP-complete 면 못 푸는 거잖아" | 매일 풉니다. 운 나쁠 때만 오래 걸립니다 |
이 이름들은 1971년에 Cook 과 Levin 이 각자, 1972년에 Karp 가 이어받아 만들었습니다. 목적은 하나였습니다 — 문제가 얼마나 어려운지 재고 분류하는 것.
정렬 문제는 complexity class 로 분류하지 않습니다. 이미 명확하게 O(n log n) 의
해결책이 있으니까요. complexity class 는 아무도 좋은 알고리즘을 못 찾은 문제를
다루려고 만든 자입니다.
1. 빠르다는 게 뭔가
P 는 다항시간에 풀 수 있는 문제입니다.
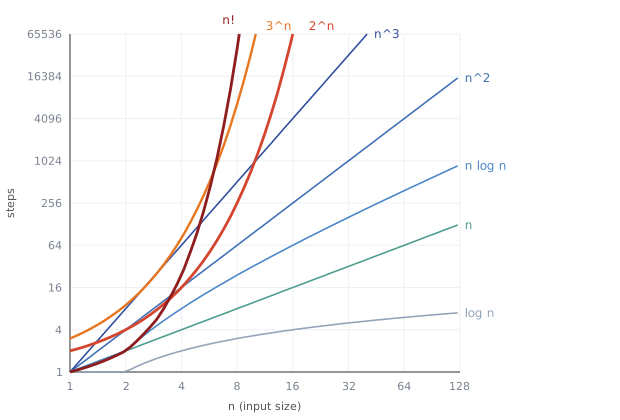
가로세로 모두 로그 눈금이라 다항식은 전부 직선이고, 붉은 쪽만 휘어
오릅니다. n³ 은 한동안 2ⁿ 위에 있는데도 n 이 10 쯤 되면 추월당합니다.
지수가 아무리 커도 직선은 직선이라서요. 이 벽 하나가 기준입니다.
그리고 앞으로 나올 이름 중 셋(P · NP · NP-complete)은 답이 "예"나 "아니오"로 나오는 문제에만 붙습니다. "이 수가 소수인가?", "미로에 출구까지 가는 길이 있나?", "지하철로 K 분 안에 갈 수 있나?" 가 P 이고, "가장 싼 길을 내놔라"처럼 답이 경로인 문제에는 안 붙습니다.
그런데 다항시간에 풀린다고 다 P 는 아닙니다. 정렬 문제가 그렇습니다. 답이 "예/아니오"가 아니기 때문에 P 라고 할 수 없습니다.
2. 완전탐색밖에 안 떠오르는 문제들
영수증이 한 뭉치 있습니다.
영수증 n 장 중에서 몇 장을 골라, 합계를 정확히 X 원으로 맞출 수 있나?
방법이 떠오르시나요. 저는 전부 해보는 것 말고는 안 떠오릅니다. 영수증마다 넣거나 빼거나 둘 중 하나니 경우의 수가 2ⁿ 입니다.
실제로 재봤습니다. 절대 만들 수 없는 금액을 목표로 줘서 끝까지 다 뒤지게 했습니다. 아래 수치는 돌려서 나온 값입니다.
    n   완전탐색(초) 앞 줄의 몇 배
   16          0.008            -
   18          0.031         3.9배        n 이 2 늘 때마다 네 배
   20          0.128         4.1배
   22          0.486         3.8배
   24          1.995         4.1배
   26          8.064         4.0배
두 장 늘 때마다 걸리는 시간이 네 배가 됩니다. 같은 컴퓨터라면 40장에 37시간, 50장에 4년입니다 — 이 둘은 재본 게 아니라 26장에서 늘린 값입니다. 영수증 50장. 많은 양이 아닙니다. 그런데 4년입니다.
이런 문제가 한둘이 아닙니다. 도시를 전부 한 번씩 도는 가장 싼 경로, 겹치지 않는 시험 시간표, 가방에 물건 채우기.
그런데 "느리다"는 이것들의 공통점이 아닙니다. 아직 이름을 안 붙이는 이유가 그겁니다. 진짜 공통점은 푸는 쪽이 아니라 채점하는 쪽에 있습니다.
3. 그런데 채점은 빠릅니다
제가 4년을 헤매는 동안 누가 와서 답을 내밉니다. "3번, 7번, 12번 영수증이요." 확인하는 데 얼마나 걸릴까요. 세 장을 더해보면 끝입니다.
  푸는 시계       고르는 방법을 전부 해본다     2ⁿ 번
  채점하는 시계   가져온 답을 더해본다           n 번
푸는 건 막막한데 채점은 전부 빠릅니다. 이런 문제를 모아 NP 라고 부릅니다.
클레이 수학연구소가 이 문제를 소개하는 첫 문장이 정확히 이 얘기입니다.
If it is easy to check that a solution to a problem is correct, is it also easy to solve the problem? This is the essence of the P vs NP question.
옮기면: 어떤 문제의 답이 맞는지 확인하기가 쉽다면, 그 문제를 푸는 것도 쉬운가? 이것이 P vs NP 질문의 핵심이다.
클레이 수학연구소 P vs NP 페이지 첫 문단에서 그대로 옮겼습니다.
N 은 non-polynomial 의 N 이 아니라 nondeterministic, 비결정적이라는 뜻입니다. 누군가 운 좋게 답을 찍어 왔다 치고 나는 채점만 한다 — 그 그림에서 나온 이름입니다.
그래서 P 는 통째로 NP 안에 들어갑니다. 직접 풀 수 있으면 채점도 되니까요. 남이 가져온 답을 무시하고 내가 다시 풀어본 다음 맞춰보면 그만입니다. 1절의 소수 판별도 미로도 전부 NP 입니다.
P ⊆ NP ⊆ 는 "안에 들어간다"
기호가 ⊆ 인 게 중요합니다. P 가 NP 보다 진짜로 좁은지는 아무도 모릅니다. 그걸
묻는 게 P vs NP 이고, 1971년 이후로 아직 안 풀렸습니다. 클레이 수학연구소의
밀레니엄 문제 일곱 개 중 하나이고, 공식 페이지를 열어보니 상금이 문제당 100만
달러입니다.
4. 문제를 바꿔 푼다 — reduction
문제 A 를 문제 B 로 바꿔서 푸는 것을 reduction 이라고 합니다. 단, 바꾸는 작업은 빨라야 합니다.
예를 들어 이런 문제가 있습니다.
  팀 나누기 — 숫자들을 합이 똑같은 두 묶음으로 나눌 수 있나?
     예)  8, 2, 5, 5   →   {8, 2} 와 {5, 5}. 둘 다 10. 예.
2절의 영수증 문제는 "몇 장을 골라 합을 목표 금액으로 맞출 수 있나?" 였습니다. 이걸 팀 나누기 문제로 바꿔 쓸 수 있습니다. 숫자 두 개만 끼워 넣으면 되고, 그러면 팀 나누기 기계가 영수증 문제를 대신 풀어줍니다.
  영수증   8  3  5  2,  목표 10        전부 더하면 18

  ① 양쪽이 각각 19 가 되게 하자       19 = 18 + 1

  ② 9 와 11 을 끼워 넣는다            9 = 19 - 10,   11 = 19 - 8

        8  3  5  2  9  11             전부 38, 반이 19

        {8, 2, 9} = 19      {3, 5, 11} = 19        나뉜다

        9 가 있는 쪽에서 9 를 빼면 {8, 2}
        8 + 2 = 10 — 영수증 문제의 답
"반으로 나뉘나?" 를 풀었더니 "10 을 만들 수 있나?" 가 풀렸습니다. 이게 reduction 입니다.
받아준 쪽이 더 어렵다
  팀 나누기 기계가 하나 있으면
      팀 나누기를 푼다       원래 하는 일
      영수증 문제도 푼다     숫자 두 개 끼워 넣고 넘기면 되니까

  A 를 B 로 바꿔 풀 수 있다   →   B 는 A 보다 쉬울 수 없다

       A = 영수증 문제,   B = 팀 나누기
팀 나누기 기계는 두 문제를 다 떠맡았습니다. 그러니 더 어려울 수도, 똑같을 수도 있지만 더 쉽지는 않습니다.
5. 네 이름을 한 그림에
  NP-hard       NP 에 있는 문제 전부가 이리로 reduction 됩니다
  NP-complete   NP-hard 인데, 자기도 NP 안에 들어 있는 것
NP-complete 은 NP 와 NP-hard 가 겹치는 칸입니다. 두 이름의 차이는 이게 전부입니다. 그리고 NP-hard 라고 해서 NP 안에 있어야 할 이유는 없습니다.
                          +------ NP-hard --------------------------------+
  +----- NP --------------+-------------------+                           |
  |                       |                   |                           |
  | +- P ---------------+ | NP-complete       |  Halting problem          |
  | | Is N prime?       | |                   |  Find cheapest route      |
  | | Maze has a path?  | | SAT               |  ^ both outside NP        |
  | | Reach B in K min? | | Subset Sum        |                           |
  | +-------------------+ | Partition         |                           |
  |                       |                   |                           |
  | Factor < K, not 1?    |                   |                           |
  | Two graphs same?      |                   |                           |
  |                       |                   |                           |
  +-----------------------+-------------------+                           |
                          +-----------------------------------------------+
P 칸은 전부 "예/아니오" 꼴로 고쳐 적은 것입니다. Subset Sum 이 영수증 문제,
Partition 이 팀 나누기입니다.
NP 칸 아래 둘은 소인수분해와 그래프 동형입니다. NP 안에 있는 건 확실한데 — 답을 주면 나눠보거나 짝지어보면 되니까요 — 어느 칸인지는 수십 년째 아무도 모릅니다. 그래서 어느 쪽 상자에도 안 넣고 띄워 뒀습니다.
Halting problem 은 "이 프로그램이 언젠가 멈출까, 영원히 돌까?"를 묻습니다. 어려운 정도가 아니라 아예 불가능합니다. 1936년 Turing 이 증명했습니다. NP 안의 문제는 느려도 언젠가는 답이 나오는데 이건 그렇지 않으니 NP 에 못 들어갑니다. 그런데도 NP-hard 입니다. NP-hard 는 NP-complete 의 약한 버전이 아니라 훨씬 넓은 이름입니다.
6. 내 문제의 complexity class 정하는 법
  ① 어느 부류인지 보고, 판정판으로 고쳐 쓴다

       판정   "되나?"              그대로
       탐색   "하나 내놔"       →  "있나?"
       최적화 "제일 좋은 거"    →  "K 이하로 되나?"

  ② 채점기를 짤 수 있나        →  NP 안에 있다
  ③ 푸는 방법을 짤 수 있나     →  P 안에 있다
  ④ 알려진 NP-hard 문제를
     내 문제로 reduction 하나  →  NP-hard

  ⑤ ② 와 ④ 가 둘 다            →  NP-complete

  ⑥ 원래 문제로 돌아온다
       판정판이 NP-complete 였다  →  원래 탐색판·최적화판은 NP-hard
②③④ 는 전부 뭔가를 만들어야 증명됩니다. 채점기, 알고리즘, reduction. ③도 ④도 안 되면 "아직 모른다"입니다. 못 찾은 건 증거가 못 됩니다 — 소인수분해와 그래프 동형이 수십 년째 거기 있습니다.
외판원으로 한 바퀴
  원래 문제    "가장 싼 경로를 내놔라"            최적화
  ① 고쳐 쓰면  "비용 K 이하로 도는 길이 있나?"    판정
고쳐 쓴 쪽에 ②~⑤ 를 돌리면 NP-complete 가 나옵니다. 경로를 받아 거리를 더해 K 와 비교하면 되니 채점이 빠르고(②), 이미 NP-complete 로 알려진 "모든 점을 한 번씩 도는 길이 있나?" 를 이 문제로 reduction 할 수 있습니다(④).
이제 원래 문제로 돌아옵니다. "가장 싼 경로"를 찾아주는 기계가 있다면, 찾아서 K 와 비교하는 것만으로 판정판도 풀립니다. 판정판이 NP-complete 이니 원래 문제는 적어도 그만큼 어렵습니다. 그래서 NP-hard 입니다. NP-complete 는 못 됩니다 — 답이 경로라 NP 에 들어갈 자격이 없으니까요.
일반적으로 "이거 NP-hard 예요"라고 말하게 되는 문제는 이 최적화판입니다.
최초의 NP-complete 문제는 누가 증명했나
④ 에는 이미 알려진 문제가 필요한데 맨 처음엔 그게 없습니다. 사다리의 첫 칸은 reduction 으로 만들 수 없습니다.
1971년 Cook 이, 1973년 Levin 이 각자 그 일을 해냈습니다. SAT 이 NP-complete
임을 정의에서 직접 증명한 겁니다. SAT 은 (A 또는 B) 그리고 (A 아니다) 같은
식을 주고 전체를 참으로 만드는 조합이 있는지 묻습니다(A=거짓, B=참).
첫 번째 NP-complete 문제 하나로 충분했습니다. 그다음부터는 SAT 에서 reduction 해 나가기만 하면 됐고, 1972년 Karp 가 21개, 1979년 Garey & Johnson 의 부록에 320개가 그렇게 쌓였습니다.
실무에서는 ④를 거의 안 합니다
내 문제가 이미 증명이 끝난 문제와 같은 꼴인 경우가 훨씬 많기 때문입니다. 그럴 땐 reduction 을 새로 짤 것 없이 남의 결론을 그대로 가져다 쓰면 됩니다.
  내 문제                 같은 꼴인 알려진 문제

  배달 순서 짜기       =  외판원         →  외판원이 NP-hard 니 이것도 NP-hard
  시험 시간표          =  그래프 색칠
  작업 배분            =  팀 나누기
  패키지 버전 맞추기   =  SAT
"어, 이거 외판원인데?" 하고 알아보는 게 실제로 쓰는 기술입니다.
7. 누가 만들었나
| 누가 | 언제 | 무엇을 했나 |
|---|---|---|
| Hartmanis · Stearns | 1965 | 분야 자체를 만들었습니다. "computational complexity" 라는 이름, 자원 한도로 문제를 묶는다는 발상(complexity class), 시간 계층 정리 |
| Cobham · Edmonds | 1965 | P 를 정의했습니다. 각자 독립으로 "다항시간 = 실용적으로 풀린다"를 제안. 그래서 Cobham–Edmonds 명제라고 부릅니다 |
| Cook · Levin | 1971 | NP-completeness 를 만들었습니다. 각자 독립으로. SAT 이 첫 번째 NP-complete |
| Karp | 1972 | 쓸모를 증명했습니다. 21개 고전 문제가 전부 NP-complete 임을 보여서, 이론이 아니라 도구가 됐습니다 |
| Garey & Johnson | 1979 | 정리했습니다. 이론서 + 320개 목록. 실무자가 찾아 쓸 수 있게 만들었습니다 |
  1965  Hartmanis · Stearns  "문제를 자원 한도로 묶자"          ← 틀
  1965  Cobham · Edmonds     "다항시간이 그 경계다"             ← P
  1971  Cook · Levin         "채점이 빠른 묶음도 있다"          ← NP, NP-complete
  1972  Karp                 "그게 현실 문제 21개에 다 걸린다"  ← 확산
  1979  Garey & Johnson      "320개를 찾아 쓰게 정리했다"       ← 사전
뒤의 둘은 발명이 아니라 적용과 정리를 했습니다. Karp 와 Garey & Johnson 이 유명한 이유도 거기 있습니다 — 책상 위 개념을 일하는 사람이 쓸 수 있게 만들었습니다.
8. 시간 말고 다른 기준들
빅오는 복잡도 이론보다 70년 앞섭니다. 수학자 Paul Bachmann 이 1894년에 만들고 Landau 가 1909년에 확장했으며, 전산학에 들여온 건 Knuth 입니다.
complexity class 도 하나가 아닙니다. 무엇을 자원으로 보느냐에 따라 기준이 갈리고, P 와 NP 는 그중 "시간" 하나입니다.
  시간      P, NP, EXP    몇 단계 만에 끝나나
  공간      L, PSPACE     메모리를 얼마나 쓰나
  무작위    BPP, RP       동전을 던져도 되면
  양자      BQP           양자 컴퓨터라면
  병렬      NC            여러 대를 동시에 쓰면
이 글이 시간만 다룬 건 그게 실무에서 제일 자주 걸리기 때문입니다.
확실하지 않은 것
P ≠ NP는 아직 아무도 증명하지 못했습니다. 겹침 그림은P ≠ NP를 가정하고 그렸습니다.- Cook 1971 의 다섯 개는 원문 전사본에서, Garey & Johnson 부록의 320개는 원본을 열어 범주별로 직접 세었습니다. Levin 1973의 6개는 영역본, Karp 1972 의 21개는 2차 자료입니다.
- 클레이 페이지가 확인해 주는 것은 "Cook 과 Levin 이 1971년에 각자 P vs NP 를 정식화했다"까지입니다. Levin 1973 은 논문 발표 연도입니다.
- 측정치는 파이썬 완전탐색 기준이라 언어와 컴퓨터가 바뀌면 절대 시간은 달라집니다. 두 장 늘 때마다 네 배라는 것만 가져가면 됩니다. 40장과 50장은 잰 게 아니라 26장(8.064초)에서 2ⁿ 으로 늘린 값입니다.
출처
이 글에 나온 숫자는 전부 여기서 직접 세었습니다.
이름을 만든 사람들
- Hartmanis · Stearns 1965 · Juris Hartmanis, Richard E. Stearns, On the Computational Complexity of Algorithms, Transactions of the AMS 117. 분야와 이름을 만든 논문. 여기서 나온 시간 계층 정리가 "어떤 칸은 진짜로 벌어져 있다"를 증명합니다. 1993년 튜링상.
- Cobham 1965 · Alan Cobham, The Intrinsic Computational Difficulty of Functions. P 를 처음 거론한 논문으로 꼽힙니다.
- Edmonds 1965 · Jack Edmonds, Paths, Trees, and Flowers, Canadian Journal of Mathematics 17. 같은 해에 따로. 둘을 묶어 Cobham–Edmonds 명제라 부릅니다.
NP 와 NP-complete
- Cook 1971 · Stephen A. Cook, The Complexity of Theorem-Proving Procedures, STOC 1971. 사다리의 첫 칸. 어려워 보이는 문제 5개를 나란히 적어뒀는데, 그중 소수 판별은 2002년에 P 로 내려갔고 그래프 동형은 아직 모릅니다. — 전사본
- Levin 1973 · Leonid A. Levin, Universal Sequential Search Problems, Problems of Information Transmission 9(3), 265–266. Cook 과 독립으로. "있나 없나"가 아니라 "찾아라" 형태의 문제 6개. — 영역본
- Karp 1972 · Richard M. Karp, Reducibility Among Combinatorial Problems, Complexity of Computer Computations, Plenum Press, 85–103. 사다리가 놓이자마자 한 논문에서 21개. — 논문 페이지
- Garey & Johnson 1979 · Michael R. Garey, David S. Johnson, Computers and
Intractability: A Guide to the Theory of NP-Completeness, W. H. Freeman.
NP-완전성만 다룬 첫 책. 부록에 320개가 실려 있고, 이름 뒤
(*)는 NP 소속이 밝혀지지 않았다는 — 즉 NP-complete 가 아니라 NP-hard 라는 — 표시입니다.
본문에 나온 나머지
- Turing 1936 · Alan M. Turing, On Computable Numbers, with an Application to the Entscheidungsproblem, Proc. London Mathematical Society. Halting problem 이 풀 수 없는 문제라는 증명.
- AKS 2002 · Manindra Agrawal, Neeraj Kayal, Nitin Saxena, PRIMES is in P, 2002년 8월 6일. 소수 판별이 P 로 내려간 날. 2006년 괴델상·풀커슨상.
- 빅오 표기 · Paul Bachmann 이 1894년에 도입하고 Edmund Landau 가 1909년에 확장했습니다. Bachmann–Landau 표기라고도 합니다.
- 클레이 수학연구소 · P vs NP · 밀레니엄 문제. 본문의 영어 인용과 상금 액수를 여기서 확인했습니다.
더 볼 것
문제 분류 1 - 유명한 문제는 75개입니다
알고리즘 문제를 기억한다는 게 푼 문제를 전부 외운다는 뜻은 아닙니다. 문제 수는 계속 늘어나지만 그 밑에 깔린 원래 문제는 그렇게 많지 않습니다. 이름이 붙어 있는 것들이 있고, 새 문제 대부분은 그중 하나를 비튼 겁니다.
그 목록을 가장 깔끔하게 정리해 둔 곳이 Steven Skiena 의 Stony Brook Algorithm Repository 입니다. 사이트가 스스로를 이렇게 소개합니다 — 가장 근본적인 문제 75개의 구현을 모아둔 곳.
1. 범주 일곱, 문제 75개
  Data Structures                   6
  Numerical Problems               11
  Combinatorial Problems           10
  Graph: Polynomial-time Problems  12
  Graph: Hard Problems             11
  Computational Geometry           16
  Set and String Problems           9
                                   --
                                   75
무엇을 다루나로 나뉩니다. 자료구조, 수, 조합, 도형, 집합과 문자열. 그래프만 둘로 쪼개져 있습니다.
Polynomial-time 과 Hard. 난이도가 범주 이름에 들어가 있습니다.
다른 범주에는 이런 게 없습니다. 어려운 문제가 그래프에만 있는 것도 아닙니다 —
Satisfiability 는 Combinatorial 에, Knapsack Problem 은 Numerical 에 그냥
들어 있습니다.
Hard 쪽은 아마 NP-hard 이거나 아직 해결책이 발견되지 않은 문제들일 겁니다.
  Polynomial-time   Shortest Path · Minimum Spanning Tree · Topological Sorting ·
                    Connected Components · Matching · Network Flow …

  Hard              Clique · Independent Set · Vertex Cover ·
                    Traveling Salesman · Hamiltonian Cycle · Vertex Coloring …
오른쪽에 내 문제가 닿으면 빠른 알고리즘을 찾는 일을 그만두면 됩니다. 수십 년간 아무도 못 찾았습니다. 대신 입력이 작다는 걸 이용하거나, 적당히 좋은 답으로 타협하거나, 가지치기로 버팁니다.
어려운 쪽 목록을 더 보고 싶으면 Garey & Johnson 1979 의 부록이 있습니다. 같은 방식으로 적힌 문제가 320개 실려 있습니다. 어려운 문제들은 NP 는 어려운 문제가 아닙니다 를 참고하세요.
2. 한 문제가 적힌 꼴
열어본 항목은 전부 같은 여덟 칸이었습니다. Topological Sorting 을 통째로
옮기면 이렇습니다.
  Topological Sorting

  Input  [figure]     dots scattered, arrows running every which way
  Output [figure]     dots in one row, every arrow pointing right

  Input Description   A directed, acyclic graph G=(V,E)
                      (also known as a partial order or poset).

  Problem             Find a linear ordering of the vertices of V such that
                      for each edge (i,j) in E, vertex i is to the left of
                      vertex j.

  Excerpt             Topological sorting arises as a natural subproblem in
                      most algorithms on directed acyclic graphs. …

  Implementations     Boost Graph Library (10) · LEDA (9) · JGraphT (8) ·
                      JDSL (8) · goraph (8) …

  Recommended Books   Sedgewick & Schidlowsky, Algorithms in Java ·
                      Cormen et al., Introduction to Algorithms ·
                      Manber, Introduction to Algorithms

  Related Problems    Bandwidth Reduction · Feedback Edge/Vertex Set ·
                      Job Scheduling · Sorting
Implementations 는 구현할 때 가져다 쓰라고 모아둔 칸입니다.
3. 비슷한 문제는 다른 범주에 있습니다
Topological Sorting 은 그래프 범주입니다. 그런데 이 문제와 비슷하다고 적혀 있는
문제 넷은 전부 다른 범주에 있습니다.
  Topological Sorting           Graph: Polynomial-time
     Sorting                       Combinatorial
     Job Scheduling                Combinatorial
     Bandwidth Reduction           Numerical
     Feedback Edge/Vertex Set      Graph: Hard
분류가 잘못된 게 아닙니다. 비슷하다는 걸 전부 범주로 표현하려 들면 범주가 끝없이
늘어납니다. Skiena 는 그렇게 하지 않고, 항목마다 Related Problems 를 달아뒀습니다.
그래서 범주는 일곱 가지로 적게 두고, 비슷한 문제는 거기서 따라가면 됩니다.
4. 알고리즘이 아니라 문제를 외웁니다
Dijkstra 를 외우면 그 알고리즘 하나가 남습니다. 대신 이렇게 외워보십시오.
  Input    간선에 가중치가 있는 그래프, 출발점 s, 도착점 t
  Output   s 에서 t 까지 가장 짧은 경로
Shortest Path 입니다. 지하철 환승도, 배송 경로도, 게임 안의 길찾기도 Input 과
Output 이 저 모양입니다. 하나를 외우면 그 꼴을 한 문제가 전부 걸립니다.
항목이 Input 과 Output 으로 적혀 있는 게 그래서 좋습니다. 새 문제를 만났을 때 맞춰볼 수 있는 꼴이거든요. 알고리즘 이름으로 외우면 그 이름을 떠올린 뒤에야 꺼낼 수 있습니다.
5. 책과의 관계
이 목록은 Skiena 의 The Algorithm Design Manual 3판 2부 "The Hitchhiker's Guide to Algorithms" 의 카탈로그를 올린 것입니다. 찾아보고 참고하라고 만든 부분이라고 사이트가 스스로 소개합니다. 2부의 장 일곱 개가 그대로 사이트의 범주 일곱 개입니다.
책 쪽이 더 긴 설명을 담고 있고, 사이트 쪽은 구현 링크가 계속 갱신됩니다.
6. 75개의 이름
이름만으로 뭘 하는 문제인지 알기 어려운 것들이 있습니다. Input, Output 은 75개 전부 에 한 줄씩 적어뒀습니다.
  Data Structures
     Dictionaries
     Priority Queues
     Suffix Trees and Arrays
     Graph Data Structures
     Set Data Structures
     Kd-Trees

  Numerical Problems
     Solving Linear Equations
     Bandwidth Reduction
     Matrix Multiplication
     Determinants and Permanents
     Constrained and Unconstrained Optimization
     Linear Programming
     Random Number Generation
     Factoring and Primality Testing
     Arbitrary-Precision Arithmetic
     Knapsack Problem
     Discrete Fourier Transform

  Combinatorial Problems
     Sorting
     Searching
     Median and Selection
     Generating Permutations
     Generating Subsets
     Generating Partitions
     Generating Graphs
     Calendrical Calculations
     Job Scheduling
     Satisfiability

  Graph: Polynomial-time Problems
     Connected Components
     Topological Sorting
     Minimum Spanning Tree
     Shortest Path
     Transitive Closure and Reduction
     Matching
     Eulerian Cycle/Chinese Postman
     Edge and Vertex Connectivity
     Network Flow
     Drawing Graphs Nicely
     Drawing Trees
     Planarity Detection and Embedding

  Graph: Hard Problems
     Clique
     Independent Set
     Vertex Cover
     Traveling Salesman Problem
     Hamiltonian Cycle
     Graph Partition
     Vertex Coloring
     Edge Coloring
     Graph Isomorphism
     Steiner Tree
     Feedback Edge/Vertex Set

  Computational Geometry
     Robust Geometric Primitives
     Convex Hull
     Triangulation
     Voronoi Diagrams
     Nearest Neighbor Search
     Range Search
     Point Location
     Intersection Detection
     Bin Packing
     Medial-Axis Transform
     Polygon Partitioning
     Simplifying Polygons
     Shape Similarity
     Motion Planning
     Maintaining Line Arrangements
     Minkowski Sum

  Set and String Problems
     Set Cover
     Set Packing
     String Matching
     Approximate String Matching
     Text Compression
     Cryptography
     Finite State Machine Minimization
     Longest Common Substring/Subsequence
     Shortest Common Superstring
출처
- Stony Brook Algorithm Repository ·
algorist.com. 범주 이름과 개수, 6절 목록, 인용한 항목을 여기서 확인했습니다. - Skiena 2020 · Steven S. Skiena, The Algorithm Design Manual, 3rd edition, Springer. 위 목록이 이 책 2부 "The Hitchhiker's Guide to Algorithms" 의 카탈로그를 올린 것입니다.
- Garey & Johnson 1979 · Michael R. Garey, David S. Johnson, Computers and Intractability: A Guide to the Theory of NP-Completeness, W. H. Freeman. 부록에 320개.
문제 분류 부록 - 75개 전부
유명한 문제는 75개입니다 에서 본 목록입니다. 문제마다 Input, Output 을 한 줄씩 적었습니다. 이름만으로는 뭘 하는 문제인지 알 수 없는 것들이 많아서요.
원문이 아니라 제가 줄여 쓴 것입니다. 정확한 정의는 Stony Brook Algorithm
Repository(algorist.com)의 각 항목에 있습니다.
Data Structures
| 문제 | In | Out |
|---|---|---|
| Dictionaries | n records, each with a key | a structure that finds, inserts and deletes a record by its key |
| Priority Queues | records with ordered keys | a structure that always hands back the smallest, and stays fast as records come and go |
| Suffix Trees and Arrays | a reference string | a structure that finds every place a query string sits inside it |
| Graph Data Structures | a graph | a representation that is small to store and quick to walk |
| Set Data Structures | a universe of objects and a family of subsets | a representation that tests membership and takes unions and intersections quickly |
| Kd-Trees | n points in k dimensions | a tree splitting the space so each point sits in its own region |
Numerical Problems
| 문제 | In | Out |
|---|---|---|
| Solving Linear Equations | a matrix A and a vector b | the x with A·x = b |
| Bandwidth Reduction | a graph that represents a sparse matrix | the ordering of vertices that makes the longest edge as short as possible |
| Matrix Multiplication | two matrices | their product |
| Determinants and Permanents | an n x n matrix | its determinant, or its permanent |
| Constrained and Unconstrained Optimization | a function of n variables | the point where it is largest, or smallest |
| Linear Programming | linear inequalities and a linear objective | values that satisfy all of them and make the objective as large as possible |
| Random Number Generation | nothing, or a seed | a sequence of integers that behaves like a random one |
| Factoring and Primality Testing | an integer n | whether n is prime, and if not, its factors |
| Arbitrary-Precision Arithmetic | two integers too big for a machine word | their sum, difference, product and quotient |
| Knapsack Problem | items with a size and a value, and a capacity | the subset of greatest value that still fits |
| Discrete Fourier Transform | n values sampled from a function at even intervals | the same signal written as a sum of frequencies |
Combinatorial Problems
| 문제 | In | Out |
|---|---|---|
| Sorting | n items | the same items in increasing order |
| Searching | n keys and a query key | where the query sits among them |
| Median and Selection | n numbers | the one with half below it and half above |
| Generating Permutations | an integer n | every ordering of n things, or a random one, or the next one |
| Generating Subsets | an integer n | every subset of 1..n, or a random one, or the next one |
| Generating Partitions | an integer n | every way to split n, or a random one, or the next one |
| Generating Graphs | a vertex count, an edge count, or an edge probability | a graph that meets them — every such graph, a random one, or the next |
| Calendrical Calculations | a month, a day and a year | the weekday it fell on |
| Job Scheduling | jobs with "this one before that one" constraints | a schedule finishing in the least time, or on the fewest machines |
| Satisfiability | clauses built from ands, ors and nots on boolean variables | whether some assignment makes every clause true |
Graph: Polynomial-time Problems
| 문제 | In | Out |
|---|---|---|
| Connected Components | a graph and a start vertex | every vertex and edge reachable from it |
| Topological Sorting | a directed acyclic graph | the vertices in a row with every edge pointing right |
| Minimum Spanning Tree | a graph with weighted edges | the cheapest set of edges that still connects everything |
| Shortest Path | a weighted graph, a start s and an end t | the cheapest route from s to t |
| Transitive Closure and Reduction | a directed graph | an edge wherever a path exists, or the fewest edges that still let you reach the same places |
| Matching | a graph, possibly weighted | the largest set of edges sharing no vertex |
| Eulerian Cycle / Chinese Postman | a graph | the shortest tour using every edge at least once |
| Edge and Vertex Connectivity | a graph, optionally two vertices | the fewest edges or vertices you can remove to break it apart |
| Network Flow | a graph with capacities, a source and a sink | the most that can be pushed from source to sink |
| Drawing Graphs Nicely | a graph | a drawing that shows its structure |
| Drawing Trees | a tree | a drawing of it |
| Planarity Detection and Embedding | a graph | whether it can be drawn with no edges crossing, and such a drawing |
Graph: Hard Problems
| 문제 | In | Out |
|---|---|---|
| Clique | a graph | the largest set of vertices all joined to each other |
| Independent Set | a graph | the largest set of vertices with no edge between any two |
| Vertex Cover | a graph | the smallest set of vertices touching every edge |
| Traveling Salesman Problem | a weighted graph | the cheapest cycle through every vertex exactly once |
| Hamiltonian Cycle | a graph | an order visiting every vertex exactly once |
| Graph Partition | a weighted graph, a size bound and a cost bound | a split into parts no bigger than the size bound, cutting no more than the cost bound |
| Vertex Coloring | a graph | a coloring of the vertices using the fewest colors, so that no two neighbors match |
| Edge Coloring | a graph | the fewest colors for the edges so that edges meeting at a vertex differ |
| Graph Isomorphism | two graphs | a relabeling that turns one graph into the other, if such a relabeling exists |
| Steiner Tree | a graph and a subset of its vertices | the smallest tree connecting that subset |
| Feedback Edge/Vertex Set | a directed graph | the fewest edges or vertices to remove so that no cycle is left |
Computational Geometry
| 문제 | In | Out |
|---|---|---|
| Robust Geometric Primitives | a point and a segment, or two segments | which side the point is on, or whether the segments cross — without rounding errors giving a wrong answer |
| Convex Hull | n points | the smallest convex polygon holding them all |
| Triangulation | a point set or a polyhedron | its interior cut into triangles |
| Voronoi Diagrams | n points | the region around each point closer to it than to any other |
| Nearest Neighbor Search | n points and a query point | the closest one |
| Range Search | n points and a query polygon | the points falling inside it |
| Point Location | a plane cut into regions, and a query point | the region it falls in |
| Intersection Detection | segments, or two polygons | which pairs cross, or the shape they share |
| Bin Packing | items with sizes, bins with capacities | a packing using as few bins as possible |
| Medial-Axis Transform | a polygon | the points inside that have more than one nearest point on the boundary — its skeleton |
| Polygon Partitioning | a polygon | a cut into as few simple pieces as possible, usually convex ones |
| Simplifying Polygons | a polygon with n vertices | one with fewer vertices that still looks like it |
| Shape Similarity | two shapes | how alike they are |
| Motion Planning | a robot, a room with obstacles, a start and an end | the shortest path that gets the robot across without hitting anything |
| Maintaining Line Arrangements | n lines and segments | the cells, edges and vertices they cut the plane into |
| Minkowski Sum | two point sets or polygons | every sum of a point from one and a point from the other |
Set and String Problems
| 문제 | In | Out |
|---|---|---|
| Set Cover | subsets of a universe | the fewest of them whose union is the whole universe |
| Set Packing | subsets of a universe | the most of them that share no element |
| String Matching | a text and a pattern | where the pattern occurs |
| Approximate String Matching | a text, a pattern, and an edit budget | whether the pattern appears somewhere after that many edits or fewer |
| Text Compression | a string | a shorter string the original can be rebuilt from |
| Cryptography | a message and a key | the encrypted text, or the message back |
| Finite State Machine Minimization | a deterministic finite state machine | the smallest one that behaves the same way |
| Longest Common Substring/Subsequence | a set of strings | the longest run of characters appearing, in order, in all of them |
| Shortest Common Superstring | a set of strings | the shortest string containing every one of them |
문제 분류 2 - 코딩 인터뷰 문제는 55개입니다
유명한 문제는 75개입니다 에서 Skiena 가 문제마다 Input, Output 을 적어둔 걸 봤습니다. 알고리즘 이름이 없어서, 손에 든 것과 원하는 것만 알면 찾아집니다.
그 75개를 코딩 인터뷰에 그대로 쓰기는 어렵습니다. Voronoi Diagrams 나
Medial-Axis Transform 은 면접에 안 나옵니다. 나오는 문제가 다릅니다.
그래서 같은 방식으로 면접 쪽 목록을 만들었습니다. LeetCode 에서 풀어본 약 3,000 문제를 다시 추렸습니다.
1. In/Out 만으로는 안 갈립니다
처음에는 Skiena 를 그대로 따라 In/Out 두 칸만 적었습니다. 그런데 이런 일이 생깁니다.
  Largest run                      합이 가장 큰 연속 구간      배열 → 수 하나
  Longest increasing subsequence   가장 긴 늘어나는 부분수열   배열 → 수 하나
둘이 구별이 안 됩니다. 연속이냐 띄엄띄엄이냐가 방법을 가르는데 In/Out 에는 안 나옵니다. 그래서 칸을 하나 더 뒀습니다.
  In             들어가는 것
  Out            나오는 것
  가르는 조건     In, Out 은 같은데 방법이 달라지는 지점
방금 둘은 여기서 갈립니다 — 연속이어야 하나?
  예        Largest run
  아니오     Longest increasing subsequence
세 번째 칸이 실제로 쓰는 칸입니다. 지문을 읽고 여기에 답할 수 있으면 방법이 정해집니다.
2. 범주 9, 문제 55
  Skiena      범주  7    문제 75      전산학 전체
  이 목록     범주  9    문제 55      면접에 나오는 것
55라는 수에 근거는 없습니다. 출발점입니다. 늘리고 줄이는 규칙만 정해뒀습니다.
  쪼갠다    그 구분이 방법이나 "왜 맞는가" 를 바꿀 때
  합친다    두 칸이 같은 추론을 낳을 때
  더한다    복습하다 반복해서 걸리는데 지금 칸으로 표현이 안 될 때
Arrays and Ranges
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Window over a sequence | 한 줄로 늘어선 수나 글자, 조건 하나 | 조건을 만족하는 가장 짧은 또는 긴 연속 구간 | 창을 넓히고 줄일 때 조건이 단조로 변하나. 합을 보는 조건이면 음수가 섞인 순간 깨진다 | Longest Substring Without Repeating Characters · Minimum Size Subarray Sum |
| Largest run | 한 줄로 늘어선 수 | 합이나 곱이 가장 큰 연속 구간 | 연속이어야 한다. 띄엄띄엄 고르면 다른 문제다 | Maximum Subarray · Maximum Product Subarray |
| Longest increasing subsequence | 한 줄로 늘어선 수나 항목 | 늘어나기만 하는 가장 긴 부분수열의 길이 | 연속이어야 하나. 띄엄띄엄 골라도 되면 끝값만 들고 이분탐색한다 | Longest Increasing Subsequence · Russian Doll Envelopes |
| Next greater element | 한 줄로 늘어선 수 | 각 자리에서 처음 만나는 더 크거나 작은 값, 또는 그렇게 정해지는 구간 | 지금 원소보다 작은 과거는 영원히 쓸모없나 | Daily Temperatures · Largest Rectangle in Histogram |
| Prefix and range | 수열이나 행렬, 그리고 반복되는 구간 질문 | 각 구간의 합이나 최소 | 중간에 값이 바뀌나. 안 바뀌면 누적합, 바뀌면 트리 | Range Sum Query - Immutable · Range Sum Query 2D - Mutable |
| Kth element | 정렬되지 않은 값들과 k | k번째로 크거나 작은 값 | k번째 하나만 필요한가, k개 전부가 필요한가 | Kth Largest Element in an Array · Top K Frequent Elements |
| Count and tally | 값들 | 몇 번 나왔나, 과반이 있나, 빠진 값이 무엇인가 | 값의 범위가 좁나. 좁으면 세기만 해도 된다 | Majority Element · First Missing Positive |
| Pair with target | 수들과 목표값 | 합이 목표가 되는 둘 또는 셋 | 정렬해도 되나. 되면 양끝, 안 되면 해시 | Two Sum · 3Sum |
Order and Priority
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Boundary by monotonicity | 정렬됐거나 단조인 것, 참거짓을 가리는 조건 | 조건이 처음 참이 되는 지점 | 답 자체가 단조인가. 그러면 값을 이분탐색한다 | Search in Rotated Sorted Array · Koko Eating Bananas |
| Two ends moving in | 정렬됐거나 정렬해도 되는 한 줄 | 양 끝에서 좁혀 얻는 짝, 넓이, 또는 개수 | 양끝에서 좁히나, 한쪽을 고정하고 좁히나 | Two Sum II - Input Array Is Sorted · Valid Triangle Number |
| Intervals | 시작과 끝이 있는 구간들 | 병합, 최대 겹침, 또는 고를 수 있는 최대 개수 | 시작으로 정렬하나 끝으로 정렬하나. 목적에 따라 갈린다 | Merge Intervals · Non-overlapping Intervals |
| Pull the best one next | 매번 가장 좋거나 나쁜 것을 꺼내야 하는 상황 | 전부 처리하고 난 결과 | 꺼낼 때마다 후보가 바뀌나. 안 바뀌면 그냥 정렬 | Merge k Sorted Lists · Meeting Rooms II |
| Sort then scan | 정렬 기준을 정해야 하는 항목들 | 한 기준으로 정렬한 뒤 한 번 훑어 얻는 답 | 한 기준을 고정하면 나머지가 단순해지나 | Largest Number · Queue Reconstruction by Height |
Grids and Matrices
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Walk a grid | 격자와 시작점 | 닿는 칸, 덩어리 수, 또는 최소 걸음 | 시작점이 하나인가 여럿인가. 여럿이면 동시에 퍼뜨린다 | Number of Islands · Walls and Gates |
| Transform in place | 행렬 | 회전, 전치, 또는 표시한 결과 | 추가 공간을 못 쓰나. 그러면 겹겹이 맞바꾼다 | Rotate Image · Set Matrix Zeroes |
| Grid DP | 격자와 칸마다의 비용 | 한 귀퉁이에서 반대편까지의 최적값 | 한 방향으로만 가나. 되돌아올 수 있으면 사이클이 없는지부터 본다 | Minimum Path Sum · Longest Increasing Path in a Matrix |
| Search a sorted grid | 행과 열이 정렬된 행렬과 찾을 값 | 있나 | 한 줄로 펴도 정렬인가. 아니면 모서리에서 시작한다 | Search a 2D Matrix · Search a 2D Matrix II |
| Simulate on a grid | 격자와 바뀌는 규칙 | 규칙을 적용한 다음 상태, 또는 변하지 않을 때까지 적용한 결과 | 갱신이 동시에 일어나나 차례로 일어나나 | Game of Life · Candy Crush |
Strings
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Palindrome | 문자열 | 회문인가, 또는 회문인 가장 긴 조각 | 가운데에서 퍼지나, 양끝에서 좁히나 | Longest Palindromic Substring · Valid Palindrome |
| Brackets and expressions | 괄호나 연산자가 섞인 문자열 | 유효한가, 계산 결과, 또는 펼친 결과 | 중첩이 있나. 있으면 스택, 없으면 세기만 | Minimum Add to Make Parentheses Valid · Basic Calculator |
| Edit distance | 문자열 둘 | 하나를 다른 하나로 바꾸는 최소 연산 수 | 허용되는 연산이 무엇인가. 교체가 빠지면 다른 문제다 | Edit Distance · Delete Operation for Two Strings |
| Common subsequence | 문자열이나 배열 둘 | 둘 다에 들어 있는 가장 긴 것 | 연속이어야 하나. 띄엄띄엄 되면 부분수열 | Longest Common Subsequence · Maximum Length of Repeated Subarray |
| Pattern in text | 긴 글과 찾을 조각 하나 또는 여럿 | 조각이 어디에 나오나 | 조각이 여럿인가. 여럿이면 트라이나 해시 | Find All Anagrams in a String · Add Bold Tag in String |
| Prefix set | 단어 여러 개 | 접두사를 공유하는 단어 찾기 | 질의가 반복되나. 한 번이면 트라이를 지을 값이 없다 | Longest Common Prefix · Word Search II |
| Same letters | 문자열 하나 또는 여럿 | 글자 구성이 같은가, 같은 것끼리 묶기 | 같은지만 보나, 같은 것끼리 묶나 | Valid Anagram · Group Anagrams |
| Rewrite a string | 규칙이 적힌 문자열 | 규칙대로 고쳐 쓴 결과 | 규칙이 한 번에 끝나나, 나온 결과에 또 적용되나 | Decode String · Count and Say |
Trees
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Walk a tree | 트리 | 방문 순서, 또는 훑으면서 모은 값 | 위에서 아래로 가져가나, 아래에서 위로 모으나 | Path Sum · Maximum Depth of Binary Tree |
| Tree DP | 트리와 노드마다의 값 | 부분 트리에서 올려 모은 최적값 | 자식이 올려보낼 값이 하나면 되나, 여럿이어야 하나 | Binary Tree Maximum Path Sum · House Robber III |
| Build a tree | 순회 결과나 직렬화된 문자열 | 원래 트리 | 뿌리를 어디서 알 수 있나 | Construct Binary Tree from Preorder and Inorder Traversal · Construct Binary Tree from Inorder and Postorder Traversal |
| Binary search tree | 정렬 성질이 있는 트리 | 삽입, 삭제, k번째, 또는 검증 | 정렬된 수열에서 트리를 만드나, 트리에서 정렬된 수열을 꺼내나 | Convert Sorted Array to Binary Search Tree · Kth Smallest Element in a BST |
| Lowest common ancestor | 트리와 두 노드 | 둘의 가장 가까운 공통 조상 | 정렬 성질을 쓸 수 있나. BST 면 뿌리에서 한 번 내려가면 끝난다 | Lowest Common Ancestor of a Binary Search Tree · Lowest Common Ancestor of a Binary Tree |
Graphs
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Connected components | 정점과 간선, 또는 격자 | 몇 덩어리인가, 둘이 같은 덩어리인가, 어느 간선이 사이클을 만드나 | 간선이 한꺼번에 주어지나 하나씩 들어오나 | Number of Connected Components in an Undirected Graph · Redundant Connection |
| Topological order | 선행 관계가 있는 일들 | 실행 순서, 또는 그런 순서가 있기는 한가 | 사이클이 있으면 답이 없다. 그 판정이 문제의 절반 | Course Schedule · Course Schedule II |
| Shortest path | 그래프와 출발점, 필요하면 도착점 | 최소 비용 또는 최소 단계 | 가중치가 전부 1인가, 음수가 있나. 방법이 셋으로 갈린다 | Word Ladder · Network Delay Time |
| Cycle | 그래프나 연결 리스트 | 사이클이 있나, 어디서 시작하나, 어디가 안 걸리나 | 다음이 하나뿐인가, 여러 갈래인가. 갈라지면 방문 중 상태를 따로 둬야 한다 | Linked List Cycle II · Find Eventual Safe States |
| Spanning and flow | 가중치나 용량이 있는 그래프 | 전부 잇는 최소 비용, 최대로 흘릴 양, 최대 짝짓기 | 두 편으로 나뉘나. 나뉘면 매칭 문제가 된다 | Min Cost to Connect All Points · Maximum Number of Accepted Invitations |
States and Choices
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Carry state forward | 단계마다 고를 수 있는 상태가 몇 가지 | 마지막 단계의 최적값 | 상태 수를 미리 아나, 입력에 따라 늘어나나 | Best Time to Buy and Sell Stock · Best Time to Buy and Sell Stock IV |
| Count the ways | 격자나 단계와 제약 | 끝까지 가는 방법의 수 | 갈 수 있는 곳이 처음부터 정해져 있나, 입력을 봐야 아나 | Unique Paths · Decode Ways |
| Interval DP | 한 줄과 구간 단위로 하는 연산 | 전체를 합치는 최적 비용 | 마지막에 무엇을 하느냐로 나뉘나 | Burst Balloons · Strange Printer |
| Knapsack | 크기와 값이 있는 것들, 한도 | 한도나 목표를 두고 고른 최적값 | 같은 걸 여러 번 쓰나. 쓰면 순회 방향이 바뀐다 | Ones and Zeroes · Coin Change |
| List every arrangement | 작은 n 과 제약 | 조건을 만족하는 배치 전부 | 가지치기가 되나. 안 되면 답이 너무 많다 | Letter Combinations of a Phone Number · Generate Parentheses |
| Small n, every subset | n 이 20 안팎, 부분집합마다 값이 다름 | 전부 따져 얻은 최적값 | 부분집합만 상태로 쓰면 되나, 지금 어디인지도 같이 들고 가야 하나 | Can I Win · Android Unlock Patterns |
| Win or lose | 번갈아 두는 게임 | 먼저 두는 쪽이 이기나 | 판이 독립된 더미로 쪼개지나. 쪼개지면 Grundy | Nim Game · Flip Game II |
Numbers
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Digits and bases | 수 하나 또는 문자열로 적힌 수 | 자릿수를 다루거나 진법을 바꾼 결과 | 자료형 범위를 넘나. 넘으면 문자열로 센다 | Reverse Integer · Excel Sheet Column Title |
| Divisors and primes | 수 하나 또는 범위 | 소수인가, 소수가 몇 개인가, 약수가 무엇인가 | 하나를 보나 범위를 보나. 범위면 체를 만든다 | Prime Palindrome · Count Primes |
| Bit tricks | 수들 | 비트 연산으로 얻는 값 | 짝이 몇 개씩 맞나. 둘이면 XOR 한 번으로 끝난다 | Single Number · Single Number II |
| Combinatorics | n 과 법, 필요하면 k | 경우의 수 | 나눗셈이 들어가나. 들어가면 역원이 필요하다 | Count All Valid Pickup and Delivery Options · Number of Ways to Reorder Array to Get Same BST |
| Chance and sampling | 무작위가 필요한 상황 | 균등하게 뽑은 결과 | 전체 크기를 미리 아나. 모르면 흘러가며 뽑는다 | Shuffle an Array · Linked List Random Node |
| Geometry | 점이나 도형 | 거리, 포함 관계, 또는 감싸는 모양 | 실수를 쓰나. 쓰면 오차가 문제의 절반이다 | Max Points on a Line · Generate Random Point in a Circle |
Data Structures
| 문제 | In | Out | 가르는 조건 | 예 |
|---|---|---|---|---|
| Design a structure | 연산 목록과 시간 제약 | 그 연산들이 전부 빠른 자료구조 | 넣을 때 일을 해두나, 꺼낼 때 하나 | Two Sum III - Data structure design · Design Twitter |
| Cache and eviction | 용량 제한과 접근 기록 | 무엇을 남기고 무엇을 버릴지 정하는 구조 | 버리는 기준이 시간인가 횟수인가 | LRU Cache · LFU Cache |
| Stack and queue discipline | 한쪽 끝에서만 넣고 빼는 규칙 | 그 규칙을 지키면서 추가 질의에 답하는 구조 | 최솟값 같은 걸 같이 물어보나 | Min Stack · Implement Stack using Queues |
| Key to value | 키와 값, 그리고 요구되는 연산 | 넣고 빼고 찾기가 전부 상수 시간인 구조 | 무작위 추출이 끼어 있나. 있으면 배열을 같이 둔다 | Design HashMap · Insert Delete GetRandom O(1) - Duplicates allowed |
| Iterate on demand | 중첩되거나 압축된 데이터 | 하나씩 꺼내 주는 반복자 | 미리 다 펼쳐도 되나. 안 되면 게으르게 만든다 | Flatten Nested List Iterator · Binary Search Tree Iterator |
| Linked list surgery | 노드로 이어진 줄 | 뒤집기, 자르기, 합치기, 사이클 찾기 | 길이를 미리 아나. 모르면 포인터 둘을 쓴다 | Remove Nth Node From End of List · Reverse Linked List II |
3. 쓰는 법
왼쪽 세 칸을 보고 오른쪽을 가립니다. 지문을 읽었을 때 가르는 조건에 답할 수 있으면 그 문제는 풀립니다. 답이 안 나오면 거기가 다시 볼 자리입니다.
문제 분류 3 - 면접장에는 칸 이름이 없습니다
코딩 인터뷰 문제는 55개입니다 의 표는 왼쪽에서 오른쪽으로 읽습니다. 원형 이름이 있고, 그 옆에 Input 과 Output 이 있습니다.
면접은 반대입니다. 지문 하나가 주어지고, 칸 이름은 안 옵니다. 그러니 쓸 수 있으려면 오른쪽에서 왼쪽으로도 읽혀야 합니다.
1. 지문에서 보이는 것
지문을 읽을 때 눈에 걸리는 것들이 있습니다. 알고리즘 이름이 아니라, 그냥 적혀 있는 것입니다.
| 지문에 보이면 | 후보 | 가르는 질문 |
|---|---|---|
| 정렬돼 있다 · 정렬해도 된다 | Two ends moving in · Boundary by monotonicity | 짝을 찾나, 경계를 찾나 |
| 연속한 구간 | Window over a sequence · Largest run | 조건을 만족하는 구간인가, 합이 최대인 구간인가 |
| 늘어나기만 하는 가장 긴 것 | Longest increasing subsequence | 연속이어야 하나 |
| 각 자리에서 처음 만나는 더 크거나 작은 것 | Next greater element | 지금보다 작은 과거가 영영 쓸모없나 |
| 구간을 여러 번 묻는다 | Prefix and range | 중간에 값이 바뀌나 |
| k번째 | Kth element · Pull the best one next | 한 번 묻나, 계속 묻나 |
| 합이 목표가 되는 둘 또는 셋 | Pair with target | 정렬해도 되나 |
| 몇 번 나왔나 · 과반 · 빠진 값 | Count and tally | 값의 범위가 좁나 |
| 어떻게 정렬할지부터 정해야 한다 | Sort then scan | 한 기준을 고정하면 나머지가 단순해지나 |
| 시작과 끝이 있는 것들 | Intervals | 시작으로 정렬하나, 끝으로 정렬하나 |
| 먼저 해야 할 일이 있다 | Topological order | 사이클이면 답이 없다 |
| 섬 · 덩어리 · 같은 그룹인가 | Connected components | 간선이 한꺼번에 오나, 하나씩 오나 |
| 사이클이 있나 | Cycle | 다음이 하나뿐인가, 여러 갈래인가 |
| 전부 잇는 최소 비용 · 최대로 흘릴 양 | Spanning and flow | 두 편으로 나뉘나 |
| 최소 비용 · 최소 걸음 | Shortest path | 가중치가 전부 1인가, 음수가 있나 |
| 격자 | Walk a grid · Grid DP · Simulate on a grid | 퍼지나, 한 방향으로만 가나, 규칙을 반복하나 |
| 행마다 정렬되고 열마다 정렬된 표 | Search a sorted grid | 한 줄로 펴도 정렬인가 |
| 행렬을 돌리거나 뒤집어라 | Transform in place | 추가 공간을 못 쓰나 |
| 트리 | Walk a tree · Tree DP | 한 번 훑으면 끝나나, 부분 트리마다 골라 가며 올라가나 |
| 순회 결과가 주어진다 | Build a tree | 뿌리를 어디서 아나 |
| 왼쪽이 작고 오른쪽이 큰 트리 | Binary search tree | 정렬된 수열을 만드나, 꺼내나 |
| 두 노드의 공통 조상 | Lowest common ancestor | 정렬 성질을 쓸 수 있나 |
| 회문 | Palindrome | 가운데에서 퍼지나, 양끝에서 좁히나 |
| 괄호나 연산자 | Brackets and expressions | 중첩이 있나 |
| 문자열이나 배열 둘 | Edit distance · Common subsequence | 고치는 비용인가, 공통인 것인가 |
| 긴 글에서 조각을 찾아라 | Pattern in text | 조각이 여럿인가 |
| 이 접두사로 시작하는 단어 | Prefix set | 질의가 반복되나 |
| 글자를 다시 배열한 것인가 | Same letters | 같은지만 보나, 같은 것끼리 묶나 |
| 규칙대로 고쳐 써라 | Rewrite a string | 규칙이 한 번에 끝나나, 나온 결과에 또 적용되나 |
| 단계마다 고른다 | Carry state forward | 상태 수를 미리 아나, 입력에 따라 늘어나나 |
| 방법이 몇 가지냐 | Count the ways · Combinatorics | 한 단계씩 세어 올라가나, 공식으로 한 번에 세나 |
| 구간을 합쳐 간다 | Interval DP | 마지막에 무엇을 하느냐로 나뉘나 |
| 한도나 목표를 두고 고른다 | Knapsack | 같은 걸 여러 번 쓰나 |
| 모든 배치를 보랜다 | List every arrangement | 가지치기가 되나 |
| 고른 것의 조합이 상태가 된다 | Small n, every subset | 부분집합만 상태로 쓰면 되나, 지금 어디인지도 들고 가야 하나 |
| 번갈아 둔다 | Win or lose | 판이 독립된 더미로 쪼개지나 |
| 하나만 빼고 짝이 맞는다 | Bit tricks | 짝이 몇 개씩 맞나 |
| 소수 · 약수 · 배수 | Divisors and primes | 하나를 보나, 범위를 보나 |
| 진법 · 자릿수 · 아주 큰 수 | Digits and bases | 자료형 범위를 넘나 |
| 무작위로 뽑아라 | Chance and sampling | 전체 크기를 미리 아나 |
| 연산 목록과 시간 제약 | Design a structure | 넣을 때 일을 해두나, 꺼낼 때 하나 |
| 용량이 차면 버려라 | Cache and eviction | 버리는 기준이 시간인가 횟수인가 |
| 한쪽 끝에서만 넣고 뺀다 | Stack and queue discipline | 최솟값 같은 걸 같이 묻나 |
| 넣고 빼고 찾기가 전부 빨라야 한다 | Key to value | 무작위 추출이 끼어 있나 |
| 하나씩 꺼내 달라 | Iterate on demand | 미리 다 펼쳐도 되나 |
| 노드가 이어져 있다 | Linked list surgery | 길이를 미리 아나 |
왼쪽은 답을 몰라도 보입니다. Monotonic Stack 은 단조 스택을 떠올려야 열리지만,
"각 자리에서 다음으로 큰 것"은 지문에 그냥 적혀 있습니다.
2편의 55개 중 하나는 여기 없습니다. Geometry 는 지문에서 알아볼 신호가
"도형이 나온다" 말고는 없습니다. 신호가 약한 칸이 있다는 것도 알아둘 만합니다 —
그런 문제는 읽자마자 아는 수밖에 없습니다.
2. 제약 조건도 지문입니다
n 의 크기가 적혀 있으면 답의 복잡도가 거의 정해집니다.
  n ≤ 20          2ⁿ            부분집합을 전부 본다
  n ≤ 40          2^(n/2)       반으로 쪼개 만나기
  n ≤ 500         n³
  n ≤ 5,000       n²
  n ≤ 10⁵         n log n       정렬 · 이분탐색 · 힙 · 세그먼트 트리
  n ≤ 10⁷         n             한 번 훑기
  값이 10⁹까지     log(값) 또는 수학  크기가 아니라 수 자체가 크다
다만 이건 좁혀주는 것이지 정해주는 것이 아닙니다. n ≤ 20 이면 비트마스크
DP 일 수도 있고 그냥 백트래킹일 수도 있습니다. 후보를 몇 개로 줄여줄 뿐입니다.
3. 후보가 둘 이상일 때
여기서부터가 진짜입니다. 신호로 후보를 둘셋 줄였는데 그중 뭘 쓸지 모를 때, 이 순서로 묻습니다.
  ① 그냥 다 해보면 어떻게 하나
  ② 그게 왜 느린가
  ③ 무엇을 다시 안 해도 되나
  ④ 그래서 뭘 쓰나
  ⑤ 그게 왜 맞나
합이 K 이상인 가장 짧은 구간 으로 해보겠습니다.
  ①  모든 구간을 본다                        n²
  ②  왼쪽 끝을 옮길 때마다 합을 처음부터 다시 더한다
  ③  왼쪽 끝을 되돌릴 일이 없다 — 오른쪽을 늘렸다 왼쪽을 당기면 된다
  ④  슬라이딩 윈도우
  ⑤  합이 K 에 닿으면 왼쪽을 당겨도 되고, 모자라면 오른쪽을 늘려야 한다.
      양쪽 다 되돌아갈 일이 없으니 각 원소를 많아야 두 번 본다
③이 답입니다. 나머지는 거기 닿기 위한 질문입니다.
그리고 ③이 안 나오면 그 문제는 아직 모르는 겁니다. 방법 이름을 떠올렸는지와는 상관이 없습니다 — "슬라이딩 윈도우"라고 말할 수 있어도 ③을 못 하면 변형이 나왔을 때 막힙니다.
여기서 음수가 섞이면 ③이 깨집니다. 왼쪽을 당겨도 합이 줄어든다는 보장이
없으니까요. 가르는 조건 칸에 그렇게 적어둔 이유입니다.
4. 복습하는 법
  왼쪽만 보고 오른쪽을 가린다        신호 → 후보 → 가르는 질문 순으로 떠올린다
  막히면 ①~⑤ 를 소리 내서 한다      ③ 에서 막히는지 ④ 에서 막히는지 확인
  틀린 것을 더 자주 본다
  맞힌 것은 시간을 두고 다시 본다     바로 다시 보면 맞히는 게 당연하다
섞을 때는 헷갈리는 것끼리 섞습니다. 아무거나 뒤섞는 게 아니라
Window over a sequence 와 Largest run 처럼 Input 과 Output 이 거의 같은
것들을 나란히 놓습니다. 물어볼 것은 하나입니다 — 왜 이건 저 방법이 되는데
옆엣것은 안 되나.
섞으면 연습할 때는 더 못합니다
이걸 수학 문제로 잰 실험이 있습니다. 대학생 18명에게 낯선 입체 네 개의 부피 구하는 법을 가르치고, 한쪽은 같은 종류끼리 묶어서 연습시키고 다른 쪽은 네 종류를 섞어서 연습시켰습니다. 문제도 개수도 똑같고 순서만 달랐습니다.
  연습하는 동안      묶은 쪽  89%     섞은 쪽  60%
  일주일 뒤 시험     묶은 쪽  20%     섞은 쪽  63%
틀린 이유가 중요합니다. 묶어서 연습한 쪽은 계산을 틀린 게 아니라 어느 공식을 쓸지를 틀렸습니다. 공식만 맞게 적으면 답은 거의 다 맞았습니다.
묶어서 풀면 어느 것인지 고를 일이 없습니다. 알려주고 시작하니까요.
Largest run 을 열 개 연속으로 풀면 열 번 다 답을 알고 시작합니다.
면접에는 그 알려주는 사람이 없습니다.
그런데 연습하는 동안에는 묶은 쪽이 더 잘합니다. 89% 대 60%. 그래서 섞으면 손해 보는 것처럼 느껴집니다. 그림을 보고 화가를 맞히는 다른 실험에서는 섞은 쪽이 더 나았던 사람이 120명 중 78% 였는데, 묶는 쪽이 낫거나 비슷했다고 답한 사람도 78% 였습니다. 시험을 치고 난 뒤에 물어봐도 그랬습니다. 느낌이 반대로 갑니다.
둘 다 실험실에서 대학생에게 잰 것입니다. 그리고 Rohrer & Taylor 는 자기 실험의 한계를 직접 넷 적어뒀는데, 그중 하나가 면접에는 제일 아픕니다 — 시험 문제가 연습 문제와 같은 꼴이어서, 처음 보는 변형에도 통하는지는 재지 않았습니다.
그리고 소리 내서 해보십시오. 면접은 푸는 시험이 아니라 푸는 과정을 보여주는 시험인데, 혼자 조용히 푸는 연습만 하면 그 부분이 훈련되지 않습니다. ①~⑤ 를 말로 하면 복습과 말하기가 같이 됩니다.
출처
- Rohrer & Taylor 2007 · Doug Rohrer, Kelli Taylor, "The shuffling of mathematics problems improves learning", Instructional Science 35:481–498. 위 수치는 Experiment 2 입니다.
- Kornell & Bjork 2008 · Nate Kornell, Robert A. Bjork, "Learning Concepts and Categories: Is Spacing the 'Enemy of Induction'?", Psychological Science 19(6):585–592. 위 수치는 Experiment 1a 입니다.
Cypher 1 - 그림을 그대로 적습니다
Neo4j 에 물어볼 때 쓰는 말이 Cypher 입니다. 표를 다루는 SQL 과 달리 node 와 edge 로 된 그림을 다룹니다.
그래서 쿼리가 그림처럼 생겼습니다. 기호 셋이 전부입니다.
  ( )       node
  -[ ]->    edge
  { }       속성
이 편에서 이 셋을 하나씩 보고, 2편 에서 그걸로 긴 길을 찾습니다.
1. node — ( )
사람 하나, 가게 하나가 node 입니다. 괄호 안에 둘을 적을 수 있습니다.
  ( )            아무 node 나
  (:Person)      Person 종류인 node
  (f)            node 하나. 뒤에서 f 라고 부르겠다
  (f:Person)     Person 종류인 node. 뒤에서 f 라고 부르겠다
:Person 을 라벨이라고 하는데, 그냥 종류라고 보면 됩니다. 앞의 f 는
이름표입니다. 결과로 꺼내거나 뒤에서 또 쓸 때만 붙이고, 안 쓸 거면
비워둡니다.
2. edge — -[ ]->
node 둘을 잇습니다. 화살표 방향이 있습니다.
  -[:KNOWS]->    KNOWS 종류의 edge 를 따라 앞으로
  <-[:KNOWS]-    거꾸로
  -[:KNOWS]-     방향은 상관없다. 어느 쪽이든 따라간다
  -[r:KNOWS]->   edge 에도 이름표를 붙일 수 있다
방향 무시가 중요합니다. (제자)-[:TRAINED_UNDER]->(스승) 처럼 한 방향으로만
저장해 둬도, 찾을 때 - 로 적으면 스승 쪽에서 제자 쪽으로도 갈 수 있습니다.
3. 속성 — { }
node 에도 edge 에도 값이 붙습니다.
  (p:Person {name: 'Mina'})      name 이 'Mina' 인 Person
  -[:KNOWS {since: 2019}]->      since 가 2019 인 KNOWS edge
4. 찾아서 꺼내기 — MATCH 와 RETURN
사람 넷이 이렇게 이어져 있다고 합시다.
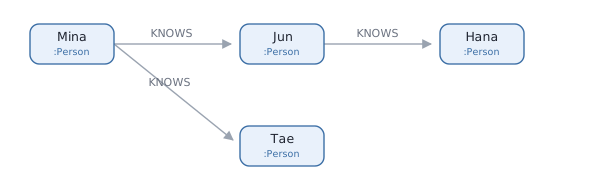
Mina 의 친구를 찾습니다.
MATCH (me:Person {name: 'Mina'})-[:KNOWS]->(f:Person)
RETURN f.name
f.name
"Jun"
"Tae"
  MATCH          이런 모양을 찾아라.  SQL 의 SELECT ... WHERE 자리
  RETURN         찾은 것 중 뭘 꺼낼지
  f.name         f 라고 이름 붙인 node 의 name 속성
찾을 모양을 그림으로 적는 게 다른 점입니다. 위 한 줄은 그림에서 Mina 에서
나가는 화살표를 눈으로 따라가는 것과 같습니다.
5. 두 단계
화살표를 한 번 더 이으면 됩니다.
MATCH (me:Person {name: 'Mina'})-[:KNOWS]->(:Person)-[:KNOWS]->(fof:Person)
RETURN fof.name
fof.name
"Hana"
가운데 (:Person) 에 이름표가 없습니다. 거쳐 가기만 하고 결과로 안 꺼내니까
비워둔 것입니다.
Tae 는 결과에 없습니다. Tae 에서 나가는 KNOWS edge 가 없어서 그림이 거기서
끊깁니다.
6. 이름 바꾸고, 줄 세우고, 자르기
MATCH (me:Person {name: 'Mina'})-[:KNOWS]->(f:Person)
RETURN f.name AS friend
ORDER BY friend
LIMIT 2
friend
"Jun"
"Tae"
  AS friend      결과 칸 이름을 friend 로 바꾼다
  ORDER BY       줄 세운다
  LIMIT          위에서 몇 개만
ORDER BY 와 LIMIT 과 AS 는 SQL 과 똑같습니다. ORDER BY 를 안 쓰면
순서는 보장되지 않습니다. 앞 절들의 결과도 순서가 달리 나올 수 있습니다.
7. MATCH 는 여러 개 쓸 수 있습니다
MATCH (me:Person {name: 'Mina'})-[:KNOWS]->(f:Person)
MATCH (f)-[:LIVES_IN]->(c:City)
RETURN f.name, c.name
앞에서 붙인 이름표는 쿼리 끝까지 살아 있습니다. 첫 줄의 f 를 둘째 줄에서
그대로 씁니다.
다만 MATCH 가 늘면 행 수가 바뀝니다. 앞 행 하나마다 뒤 모양이 맞는
만큼 행이 생깁니다 — 하나도 안 맞으면 그 행은 사라지고, 셋이 맞으면 세
행이 됩니다.
위 쿼리는 둘째 MATCH 가 f 로 앞과 이어져 있어서 그렇습니다. 안 이어진
모양을 쓰면 다릅니다.
MATCH (f:Person)
MATCH (c:City)
이러면 사람 3명과 도시 4곳이 모든 짝으로 12행이 됩니다. 많이 이을 때는
중간에 WITH ... LIMIT 이나 DISTINCT 로 줄입니다. WITH f, c 를 쓰면 그
뒤로는 f 와 c 만 남습니다.
8. 값은 밖에서 넣습니다
MATCH (me:Person {id: $userId})-[:KNOWS]->(f:Person)
RETURN f.name
$userId 는 쿼리를 부를 때 넣는 값입니다. 이름을 쿼리에 박아 넣지 않고
비워두는 자리입니다.
9. 목록 다루기와 |
Cypher 는 목록을 자주 돌려줍니다. 목록을 한 번에 바꾸는 문법이 있습니다.
[x IN 목록 | 바꿀 식]
파이썬의 [바꿀 식 for x in 목록] 과 앞뒤만 뒤집힌 모양입니다. 실제로
돌려보면 이렇습니다.
RETURN [n IN [1, 2, 3] | n * 10] AS tenfold
tenfold
[10, 20, 30]
n 은 목록에서 하나씩 꺼낸 것이고, | 뒤가 그걸 어떻게 바꿀지입니다.
| 는 뜻이 둘입니다
같은 기호가 다른 자리에서 다른 일을 합니다. 헷갈리기 쉬운 자리라 미리 갈라둡니다.
  [x IN 목록 | 식]      목록 안에서는  "각각 이렇게 바꿔라"
  -[:A|B]->             edge 안에서는  "A 또는 B"
두 번째는 KNOWS 든 WORKS_WITH 든 아무거나 따라가라는 뜻입니다.
MATCH (me:Person {name: 'Mina'})-[:KNOWS|WORKS_WITH]->(f:Person)
RETURN f.name
KNOWS 로 이어진 사람도, WORKS_WITH 로 이어진 사람도 다 나옵니다.
그리고 * 를 붙이면
2편에서 이런 모양을 만납니다. 조각으로 나눠 보면 새로울 게 없습니다.
  [:A|B|C*1..3]

  [: ... ]        edge 자리
  A|B|C           A 또는 B 또는 C
  *1..3           지나는 edge 가 1개에서 3개까지
*1..3 의 숫자는 지나는 edge 의 개수입니다. node 개수가 아닙니다. edge 를
두 개 지나면 node 는 셋을 밟습니다.
  (X) --A--> (Y)                edge 1개.  바로 옆
  (X) --A--> (Y) --C--> (Z)     edge 2개.  한 다리 건너
그래서 이 숫자를 거리라고 보면 됩니다. *1..3 은 "거리 1에서 3 사이에
있는 것" 입니다.
그리고 * 는 edge 종류 전체에 걸립니다. 세 종류를 섞어가며 가도 됩니다 —
위 둘째 줄처럼 A 로 한 번, C 로 한 번 가는 길도 거리 2로 걸립니다.
// 로 시작하는 줄은 주석입니다.
다음 편
두 단계면 -[:KNOWS]-> 를 두 번 쓰면 됩니다. 그런데 몇 단계인지 모르면
어떻게 할까요. 한 단계일 수도 세 단계일 수도 있다면요.
2편 이 거기서 시작합니다.
Cypher 2 - 몇 단계 건너야 하는지 몰라도 됩니다
1편 에서 -[:KNOWS]-> 를 두 번 이어 친구의 친구를
찾았습니다. 그런데 몇 단계인지 모를 때가 더 많습니다.
여기서는 그런 길을 한 줄로 적습니다.
1. 이런 데이터가 있다고 합시다
사람과 식당과 도시가 edge 로 이어져 있습니다.
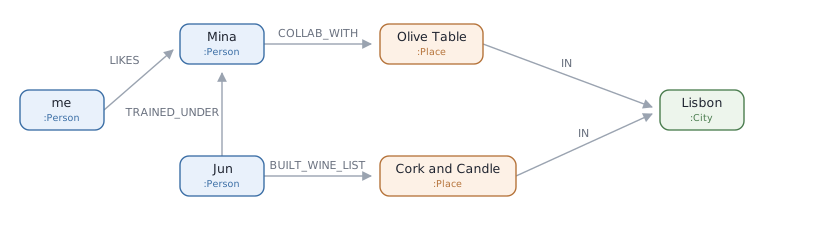
me 는 Mina 를 좋아하고, Mina 는 Olive Table 과 협업했습니다. 그리고
Jun 은 Mina 밑에서 배웠고 Cork and Candle 의 와인 목록을 짰습니다.
내가 좋아하는 사람과 이어진 리스본 식당을 찾아보겠습니다. 한 단계일 수도 있고 세 단계일 수도 있습니다.
2. 쿼리 한 개
MATCH (me:Person {id: $userId})-[:LIKES]->(s:Person)
MATCH path = (s)-[:TRAINED_UNDER|COLLAB_WITH|BUILT_WINE_LIST*1..3]-(p:Place)
      -[:IN]->(:City {name: 'Lisbon'})
RETURN p.name,
       [r IN relationships(path) | type(r)] AS why,
       length(path) AS hops
ORDER BY hops
LIMIT 3
1편에 없던 게 넷뿐입니다.
  path =                찾은 길 전체에 이름을 붙인다
  [:A|B|C]              A 또는 B 또는 C edge
  *1..3                 지나는 edge 가 1개에서 3개까지 — 거리 1~3
  relationships(path)   길에 있는 edge 목록
나머지는 1편에서 본 것입니다 — $userId, MATCH 두 개, 이름표 없는 node,
[x IN 목록 | ...], AS, ORDER BY, LIMIT.
3. 한 줄씩
첫 번째 MATCH
  (me:Person {id: $userId})    id 가 $userId 인 Person 을 me 라고 부른다
  -[:LIKES]->(s:Person)        me 가 LIKES 한 사람을 s 라고 부른다
그림에서 s 는 Mina 입니다.
두 번째 MATCH
여기가 이 편의 핵심입니다.
  *1..3                  거리가 1~3 사이면 된다. 몇인지 몰라도 된다
  끝이 -> 가 아니라 -    방향을 무시한다
  [:A|B|C]               세 종류 중 아무 edge 나
  (p:Place)              도착은 식당. 이름표는 p
  -[:IN]->(:City {...})  리스본에 있어야 한다
*1..3 이 없으면 1단계용·2단계용·3단계용 쿼리를 따로 써야 합니다. 그리고
1편에서 본 대로 세 종류를 섞어서 건너도 됩니다 — 아래 길 B 가 그렇습니다.
그리고 끝이 - 라서 거꾸로도 따라갑니다. Jun 이 Mina 밑에서 배웠다는
edge 는 Jun → Mina 방향인데, Mina 에서 출발해 거슬러 Jun 으로 갈 수
있습니다.
도시는 결과로 안 꺼내니까 (:City ...) 에 이름표가 없습니다. 1편에서 본 그
자리입니다.
찾아지는 길이 둘입니다.
  A   Mina --COLLAB_WITH--> Olive Table --IN--> Lisbon            edge 2개
  B   Mina <--TRAINED_UNDER-- Jun
           --BUILT_WINE_LIST--> Cork and Candle --IN--> Lisbon    edge 3개
RETURN
  p.name                   식당 이름
  relationships(path)      길에 있는 edge 목록
  [r IN 목록 | type(r)]    edge 마다 종류 이름만 꺼낸다
  length(path)             길 전체의 edge 개수. 곧 거리
4. 결과
p.name              why                                        hops
"Olive Table"       ["COLLAB_WITH", "IN"]                      2
"Cork and Candle"   ["TRAINED_UNDER", "BUILT_WINE_LIST", "IN"] 3
hops 가 *1..3 의 범위를 넘는 것처럼 보이는데 맞습니다. *1..3 은
가운데 토막에만 걸리고, length(path) 는 마지막 -[:IN]-> 까지 센
것입니다. 길 B 는 가운데가 2개, IN 이 1개라 3입니다.
why 가 쓸모 있습니다. 식당 이름만 돌려주면 "왜 이걸 추천했지" 를 설명할
수 없는데, edge 종류가 같이 나오니 "Olive Table 은 네가 좋아하는 Mina 랑
콜라보했어" 라고 말할 수 있습니다.
5. SQL 로 쓰면
*1..3 한 줄이 1단계·2단계·3단계 JOIN 을 각각 쓰고 UNION 으로 합치는
일이 됩니다. 아니면 WITH RECURSIVE 를 꺼내야 합니다. 거기에 edge 종류 셋과
방향 무시까지 넣으면 더 길어집니다.
자주 묻는 것
*1..3 의 숫자를 키우면 느려집니다. 건너갈 수 있는 길이 단계마다 불어나서
그렇습니다. 쓸 만한 범위를 적어두는 게 낫습니다.
Multi-turn Agent Eval 1 - 정답지를 미리 쓸 수 없습니다
한 턴 평가는 시험지와 같습니다. 질문을 주고, 답을 받고, 정답과 비교합니다.
  질문    프랑스의 수도는?
  답      파리
  정답    파리                → 맞음
agent 는 이렇게 일하지 않습니다. 항공권을 바꿔 달라는 사용자와 몇 번을 주고받으며 예약 번호를 묻고, 규정을 확인하고, 바꿔도 되는지 다시 묻고, 그다음에 바꿉니다. 이걸 재는 게 여러 턴(multi-turn) 평가입니다.
Moonshot AI 의 Kimi K2 기술 보고서(2025년 7월)도 여러 턴 능력을 따로 쟀습니다. τ2-Bench(2025년 6월), ACEBench(2025년 1월), MultiChallenge(2025년 1월) 세 시험으로요.
1. 여러 턴 평가는 두 가지입니다
다음 사용자 말을 누가 쓰느냐로 갈립니다.
  써 둔 대화    사용자 말을 미리 써 둔다. agent 의 답이 달라도 다음 말은 같다
                앞의 대화를 읽고 이해하는지 본다           예: MultiChallenge
  LLM 사용자    LLM 이 사용자를 흉내 내며 agent 의 답을 보고 다음 말을 쓴다
                주고받으며 일을 끝내는지 본다              예: τ2-Bench
둘 다 여러 턴 평가입니다. 앞쪽은 앞의 대화를 기억해야 맞히고, 뒤쪽은 실제로 주고받아야 끝납니다.
2. 다음 사용자 말을 미리 쓸 수 없습니다
같은 첫 마디로 시작해도 agent 의 답에 따라 대화가 갈립니다.
  사용자   다음 주 비행기를 하루 늦추고 싶어요
  agent A  예약 번호를 알려주시겠어요?
  사용자   ABC123 이요                          ← 이런 말이 이어진다

  agent B  네, 하루 늦췄습니다
  사용자   잠깐, 어떤 예약을 바꾼 거예요?       ← 이런 말이 이어진다
두 번째 사용자 말은 agent 의 첫 답을 보기 전에는 쓸 수 없습니다. 그래서 써 둔 대화 시험은 사용자 말을 미리 정해 두고, 대개 앞의 AI 답까지 써 둡니다. LLM 사용자 시험은 사용자를 LLM 에게 맡깁니다. 앞쪽은 모든 agent 가 같은 사용자 말을 받지만 그 말이 agent 의 답에 맞춰 달라지지 않고, 뒤쪽은 대화가 진짜처럼 이어지지만 흉내 내는 쪽도 틀리고 매번 다르게 말합니다.
3. 무엇을 채점할지가 정해지지 않습니다
같은 일을 하는 길이 여러 개입니다. 예약 번호를 먼저 물어도 되고 이름부터 물어도 됩니다. τ-bench(2024년 6월)는 그래서 대화의 순서를 정답으로 두지 않고, 끝난 뒤의 데이터베이스 상태를 정답 상태와 비교합니다. 사용자에게 꼭 알려야 할 값을 말했는지도 함께 봅니다.
끝 상태가 없는 대화도 있습니다. 조언을 구하거나 글을 고치는 대화입니다. MultiChallenge(2025년 1월) 논문은 "there is no single ground-truth answer for most test conversations" 라고 적었습니다. 이런 대화는 다른 채점법이 필요합니다. 3편에서 봅니다.
4. 같은 과제도 매번 다르게 흘러갑니다
사용자 쪽도 LLM 이 말하니, 같은 과제를 다시 돌리면 대화가 달라집니다. τ-bench 는
그래서 같은 과제를 k번 돌려 k번 다 성공할 확률을 잽니다. 이름이 pass^k
입니다.
  pass@k   k번 중 한 번이라도 성공      시도할수록 오른다    코드 평가에서 흔하다
  pass^k   k번 모두 성공                시도할수록 내려간다  고객 응대에 맞다
gpt-4o 는 τ-bench 소매 분야에서 pass^1 이 약 61% 인데 pass^8 은 약 25% 입니다. 한 번 돌리면 열에 여섯은 성공하는데, 여덟 번 연속 성공하는 과제는 넷에 하나입니다.
5. 흉내 내는 사용자도 틀립니다
τ2-Bench(2025년 6월) 논문이 사용자 시뮬레이터의 실수를 대화를 읽으며 셌습니다. 치명적 오류는 과제를 끝낼 수 없게 만드는 실수입니다 — 사용자 목표와 반대되는 요구를 하거나, 되돌릴 수 없는 상태로 만드는 것입니다.
                                     읽은 대화   오류        치명적 오류
  항공 (τ-bench 에서 가져온 분야)    100         47 (47%)    13 (13%)
  소매 (τ-bench 에서 가져온 분야)    50          20 (40%)    6 (12%)
  통신 (τ2-Bench 가 새로 만든 분야)  50          8 (16%)     3 (6%)
비율은 모두 읽은 대화 수가 분모입니다.
LLM 사용자 시험의 점수에는 늘 시뮬레이터의 실수가 섞여 있습니다. 사용자 LLM 에게 무엇을 어떻게 시키느냐가 그래서 중요하고, 5편이 그 프롬프트를 모아 봅니다.
6. 채점하는 LLM 도 대화를 따라가지 못합니다
끝 상태가 없으면 LLM 이 읽고 채점해야 하는데, 대화가 길면 채점하는 LLM 도 헷갈립니다. MultiChallenge 논문은 대화를 통째로 주고 판정시켰더니 사람과 37% 맞았고, 사람이 문제마다 yes / no 질문 하나를 써 두자 94% 맞았다고 적었습니다.
그래서 정해야 할 것
  다음 사용자 말을 누가 쓰나   미리 써 둔 기록 · 흉내 내는 LLM · 사람
  agent 가 몇 번 답하나        마지막 한 번 · 턴마다
  무엇을 채점하나              마지막 답 · 끝 상태 · 여러 번 돌린 결과
6편에서 내 agent 를 잴 때 이 셋을 어떻게 고를지 제안합니다.
출처
- 논문 이름 옆의 연월은 arXiv 에 처음 올라온 달입니다.
- Kimi Team 2025 · Kimi K2: Open Agentic Intelligence.
arXiv:2507.20534. - Yao 외 2024 · τ-bench: A Benchmark for Tool-Agent-User Interaction in
Real-World Domains.
arXiv:2406.12045. 끝 상태 비교,pass^k, gpt-4o 의 61% · 25%. - Barres 외 2025 · τ2-Bench: Evaluating Conversational Agents in a
Dual-Control Environment.
arXiv:2506.07982. 시뮬레이터 오류 수(Table 2). 통신 분야의 치명적 오류를 본문은 6%, 표 설명은 "no critical errors were reported" 로 적어 서로 다릅니다. 본문을 따랐습니다. - Sirdeshmukh 외 2025 · MultiChallenge.
arXiv:2501.17399. 채점 일치율 37.33% · 93.95% (Table 4). - 2절의 항공권 대화는 설명하려고 지어낸 예입니다.
Multi-turn Agent Eval 2 - 써 둔 대화에서 LLM 사용자로 옮겨 왔습니다
1편에서 여러 턴 평가를 두 가지로 나눴습니다. 다음 사용자 말을 미리 써 두느냐, LLM 이 agent 의 답을 보고 쓰느냐입니다. 2023년 이후 나온 방법 열세 가지를 그 둘로 나눠 시대순으로 놓으면 이렇습니다.
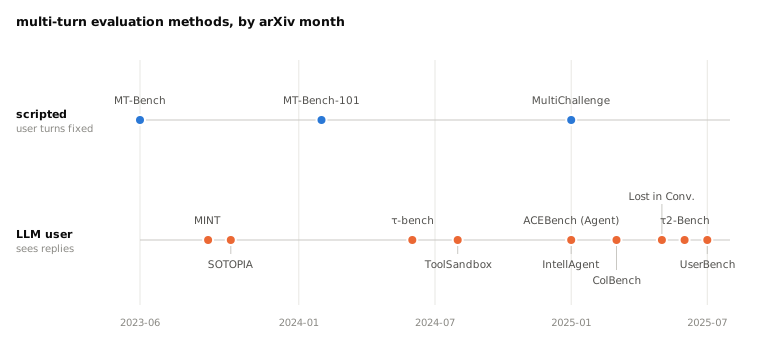
써 둔 대화는 세 개뿐이고, 2024년부터는 LLM 사용자가 대부분입니다. 사용자를 LLM 에게 맡기는 방법이 자리 잡으면서 agent 가 실제로 주고받는 능력을 재는 쪽으로 옮겨 왔습니다.
1. 한 줄씩
  나온 때   이름            사용자 말   다음 턴을 누가                무엇을 채점
  2023-06   MT-Bench        써 둔       써 둔 2턴째 질문              GPT-4 가 1~10점 · 둘 비교
  2023-09   MINT            LLM         GPT-4 가 피드백 주는 사용자   턴 예산 안에 성공했나
  2023-10   SOTOPIA         LLM         역할극 상대(agent · 사람)     7개 항목, 사람과 GPT-4 판정
  2024-02   MT-Bench-101    써 둔       써 둔 정답 기록               턴마다 GPT-4, 가장 낮은 턴
  2024-06   τ-bench         LLM         LLM 사용자                    끝 상태 · pass^k
  2024-08   ToolSandbox     LLM         LLM 사용자                    중간 단계와 끝 상태
  2025-01   ACEBench        둘 다       gpt-4o 사용자                 끝 상태 + 호출 과정
  2025-01   MultiChallenge  써 둔       써 둔 기록                    문제마다 yes / no 질문
  2025-01   IntellAgent     LLM         정책에서 만든 사용자 agent    정책을 지켰나
  2025-03   ColBench        LLM         LLM 협업자                    unit test · 화면 유사도
  2025-05   Lost in Conv.   LLM         조각을 하나씩 주는 사용자     같은 과제의 한 턴 점수와 비교
  2025-06   τ2-Bench        LLM         LLM 사용자 (tool 도 씀)       끝 상태 등 5가지 · pass^k
  2025-07   UserBench       LLM         선호를 흘리는 사용자          의도를 모두 맞췄나
ACEBench 는 묶음에 따라 다릅니다. 정해진 문항(Normal)은 써 둔 대화이고, Agent 문항만 LLM 사용자입니다. 연대표에는 Agent 문항으로 넣었습니다.
2. 써 둔 대화 — agent 가 몇 번 답하나가 다릅니다
  MT-Bench        1턴과 2턴에 모두 답한다. 2턴 질문은 1턴 답과 상관없이 같다
  MT-Bench-101    턴마다 답하되, 앞 턴들은 미리 써 둔 정답으로 채운다 (golden context)
  MultiChallenge  앞 턴들을 다른 모델이 쓰고 사람이 고쳤다. 마지막 턴에만 답한다
MT-Bench-101 은 이유를 이렇게 적었습니다. 모델이 앞에서 한 번 삐끗하면 뒤의 대화가 어색해져서 공정하게 비교할 수 없다는 겁니다. 대신 자기 실수에서 회복하는 능력은 보지 못합니다. 3편이 MultiChallenge 를 자세히 봅니다.
3. LLM 사용자 — 사용자를 어떻게 흉내 내나가 다릅니다
일을 끝내는지 보는 쪽. τ-bench, ToolSandbox, ACEBench, τ2-Bench 는 agent 가 tool 로 예약을 바꾸고 설정을 고치게 하고, 끝난 뒤의 상태를 봅니다. ToolSandbox 는 끝만이 아니라 반드시 거쳐야 할 단계(milestone)와 밟으면 안 되는 단계(minefield)도 봅니다. 4편이 τ2-Bench 를 자세히 봅니다.
IntellAgent 는 끝 상태 대신 정책을 봅니다. 회사 정책 문서에서 시나리오를 자동으로 만들고, 대화가 끝나면 판정 LLM 이 대화를 읽고 어떤 정책을 시험했고 어떤 정책을 어겼는지 적습니다. 공개 벤치마크가 없는 분야에도 쓸 수 있습니다.
대화로 알아내는지 보는 쪽. 사용자가 처음부터 다 말하지 않습니다.
  MINT            틀리면 GPT-4 가 선생님처럼 방향만 알려준다
  Lost in Conv.   과제를 조각내서 한 턴에 하나씩 준다
  UserBench       목표를 흐릿하게 시작해 선호를 은근히 흘린다
Lost in Conversation 의 방법이 가장 깔끔합니다. 같은 과제를 한 번에 다 주는 것과 조각내 여러 턴에 주는 것을 비교하니, 여러 턴 때문에 잃는 몫이 바로 나옵니다. 최신 모델들이 평균 39% 떨어졌습니다. 논문의 표현으로 "when LLMs take a wrong turn in a conversation, they get lost and do not recover" 입니다.
UserBench 는 사용자의 의도를 모두 맞춘 답이 평균 20% 였고, 가장 좋은 모델도 알아낸 선호가 전체의 30% 미만이었다고 적었습니다.
함께 만들거나 어울리는 쪽. ColBench 는 LLM 이 맡은 협업자와 주고받으며 백엔드 코드(unit test 로 채점)와 웹 화면(정답 화면과의 이미지 유사도로 채점)을 만듭니다. SOTOPIA 는 사회적 목표가 있는 역할극을 하고 목표 달성 등 7개 항목을 사람과 GPT-4 가 판정합니다.
4. Kimi K2 가 고른 셋
Kimi K2(2025년 7월)는 여러 턴 능력을 이 셋으로 쟀습니다.
  τ2-Bench        2025-06   LLM 사용자   tool 로 일을 끝내나       66.1
  ACEBench        2025-01   둘 다        tool 을 맞게 부르나       76.5
  MultiChallenge  2025-01   써 둔 대화   긴 대화를 놓치지 않나     54.1
LLM 사용자 쪽 둘과 써 둔 대화 하나입니다. 다만 ACEBench 76.5 는 Agent 문항만이 아니라 "overall on ACEBench English", 세 묶음을 합친 점수라 여러 턴만의 점수는 아닙니다.
출처
- 날짜는 arXiv 에 처음 올라온 달입니다. 각 방법이 무엇을 하는지는 초록과 본문에서, 숫자는 본문에서 옮겼습니다.
- Zheng 외 2023 · Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena.
arXiv:2306.05685. - Wang 외 2023 · MINT.
arXiv:2309.10691. - Zhou 외 2023 · SOTOPIA.
arXiv:2310.11667. - Bai 외 2024 · MT-Bench-101.
arXiv:2402.14762. - Yao 외 2024 · τ-bench.
arXiv:2406.12045. - Lu 외 2024 · ToolSandbox.
arXiv:2408.04682. - Chen 외 2025 · ACEBench.
arXiv:2501.12851. - Sirdeshmukh 외 2025 · MultiChallenge.
arXiv:2501.17399. - Levi · Kadar 2025 · IntellAgent.
arXiv:2501.11067. 정책 판정은 3.3절 Dialog Critique. - Zhou 외 2025 · SWEET-RL (ColBench).
arXiv:2503.15478. - Laban 외 2025 · LLMs Get Lost In Multi-Turn Conversation.
arXiv:2505.06120. - Barres 외 2025 · τ2-Bench.
arXiv:2506.07982. - Qian 외 2025 · UserBench.
arXiv:2507.22034. - Kimi Team 2025 · Kimi K2.
arXiv:2507.20534. 점수는 Table 3, ACEBench 가 전체 점수라는 건 평가 절입니다.
Multi-turn Agent Eval 3 - MultiChallenge 는 대화를 고정하고 답 하나만 채점합니다
이 논문은 사람과 여러 턴 대화하는 능력을, 최신 모델도 틀리는 문제로 자동 채점하려고 만든 것입니다.
Scale AI 가 2025년 1월에 냈습니다. 논문은 기존 여러 턴 벤치마크에서는 최신 모델들이 거의 만점을 받는다고 지적합니다. 그래서 그 모델들이 실제로 틀리는 대화만 모았고, 결과는 모두 50% 아래였습니다.
1. 네 가지를 묻습니다
  범주                        문제    보는 것
  Instruction retention       69      첫 턴에 준 지시를 끝까지 지키나
  Inference memory            113     앞에서 흘린 사용자 정보를 알아서 챙기나
  Reliable versioned editing  41      여러 번 고친 글에서 맞는 버전을 이어 고치나
  Self-coherence              50      사용자가 의심하면 앞의 맞는 답을 버리나
마지막 줄은 아첨(sycophancy) 문제입니다. 사용자가 같은 걸 다시 묻거나 살짝 의심하면 모델이 자기가 앞에서 한 맞는 말을 버리고 사용자 편을 듭니다. 논문은 이게 대화를 어색하게 만들고 신뢰를 떨어뜨린다고 적었습니다.
2. 문제 하나가 이렇게 생겼습니다
공개된 파일 benchmark_questions.jsonl 의 한 줄이 문제 하나입니다. Inference
memory 문제 하나를 펼치면 이렇습니다.
  AXIS            INFERENCE_MEMORY
  CONVERSATION
    user        "... I prefer venues that are within a 5-minute walk from the
                 UN headquarters."
    assistant   "... Here are a few suggestions that are within a 5-minute walk:
                 ..."
    user        "I am meeting a German diplomat on Friday. I am looking for a
                 suitable place to have lunch with him, preferably an up-class
                 restaurant. ..."
  TARGET_QUESTION "Are the restaurants chosen within a 5-minute walk from the
                   UN headquarters?"
  PASS_CRITERIA   "YES"
대화는 user 턴으로 끝납니다. 모델은 그 마지막 턴에 답 하나만 씁니다. 마지막 턴은 "걸어서 5분" 을 다시 말하지 않습니다. 첫 턴을 기억해서 스스로 챙겨야 합니다.
  CONVERSATION      user · assistant 가 번갈아 나오는 대화. 평균 9.1턴 (3~19)
  TARGET_QUESTION   답만 보고 yes / no 로 답할 수 있는 질문. 사람이 썼다
  PASS_CRITERIA     통과하려면 나와야 하는 답. 273개 모두 "YES"
읽는 건 여러 턴, 쓰는 건 한 턴입니다. 1편의 "써 둔 대화" 입니다. 마지막 턴만 보면 아무 고급 식당이나 답해도 되는데, 첫 턴을 써야 맞으니 여러 턴 시험입니다. 그래서 모델이 앞에서 실수하고 바로잡는 능력은 볼 수 없지만, 모든 모델이 같은 기록에서 시작하니 같은 조건으로 비교할 수 있습니다.
3. 문제를 이렇게 만들었습니다
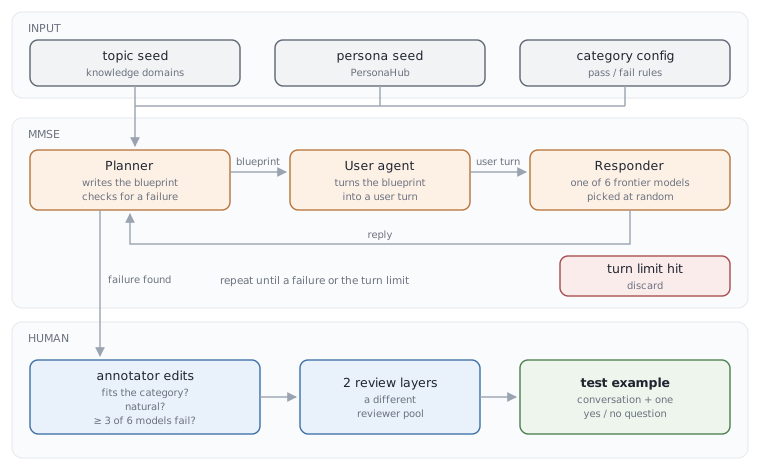
이 그림은 시험 문제를 만드는 과정입니다. 내 agent 를 잴 때는 돌리지 않고, 만들어진 파일만 씁니다. 채점하는 과정은 4절의 그림입니다.
LLM agent 셋이 대화를 지어냅니다. 논문은 이 장치를 MMSE 라고 부릅니다.
  Planner      주제 · 인물 · 범주 정의를 받아 대화의 설계도(blueprint)를 쓴다
               대화가 이어질 때마다 설계도를 고치고, 상대가 틀렸는지 판단한다
  User agent   설계도를 실제 사용자 말로 바꾼다. 상대가 틀리도록 유도한다
  Responder    답하는 쪽. 최신 모델 6개 중 하나를 문제마다 무작위로 뽑는다
Planner 가 실패를 찾으면 멈추고 저장하고, 턴 제한까지 못 찾으면 버립니다. 저장된 대화는 사람이 고칩니다. 범주에 맞는지, 자연스러운지, 그리고 최신 모델 6개 중 3개 이상이 틀리는지를 봅니다. 그다음 처음 고친 사람들과 겹치지 않는 검토자들이 두 단계로 더 검토합니다.
LLM 이 먼저 지어 두니 사람의 일이 줄었습니다. 문제 하나에 처음부터 쓰면 154.4분, 고쳐 쓰면 73.6분이 걸렸습니다. 고치기 전과 후의 문자열 유사도(Levenshtein 거리 기준)는 평균 74.5% 였고, 저자들은 나머지 25.5% 를 사람이 고친 몫으로 봤습니다.
4. 채점은 질문 하나로 합니다
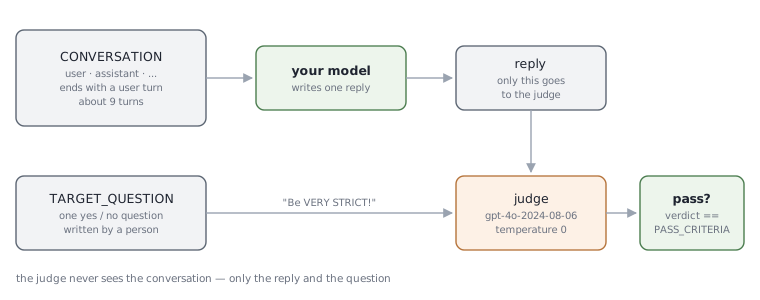
판정하는 모델은 대화를 보지 않습니다. 모델의 답과 yes / no 질문만 받습니다. 저자 코드의 판정 프롬프트 원문 전체입니다.
  You are tasked with evaluating a model response to see if it meets a specific criteria.
  The criteria will always be YES/NO evaluation.
  The model response is as follows:
  <MODEL_RESPONSE>
  {}
  </MODEL_RESPONSE>
  The criteria that the model response must meet is as follows. Be VERY STRICT!:
  <CRITERIA>
  {}
  </CRITERIA>
  Print your reasoning followed by your verdict, either "YES" or "NO".
{} 두 자리에 차례로 모델의 답과 TARGET_QUESTION 이 들어갑니다(빈 줄은 줄였습니다).
판정은 gpt-4o-2024-08-06 이 온도 0 으로 하고, 판정이 PASS_CRITERIA 와 같으면 통과입니다.
왜 대화를 안 보여주나. 대화 전체와 범주의 성공 · 실패 기준을 주고 판정시키면 사람과 37.33% 맞았습니다. 질문 하나만 주면 93.95% 맞았습니다. 논문의 설명은 이렇습니다. 판정을 맡을 모델들 자신이 이 시험에서 50% 를 못 넘는데, 대화를 읽고 남의 답을 제대로 판정하리라 믿기 어렵다는 것입니다. 질문 하나로 줄이면 판정은 답 안에 견과류가 있나, 식당이 5분 거리인가 같은 단순한 확인이 됩니다.
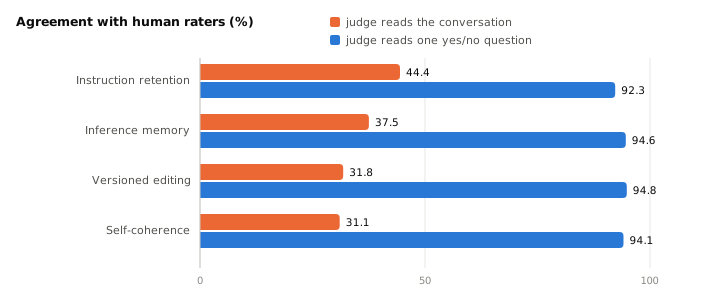
전체 점수는 범주 넷의 점수를 단순 평균합니다. 41문제짜리 범주와 113문제짜리 범주가 같은 무게입니다.
5. 코드가 있습니다
논문이 직접 링크한 ekwinox117/multi-challenge 에 데이터 273개, 채점 코드, 논문에서 잰 모델 12개의 답이 들어 있습니다. 쓰는 방법입니다.
  답을 이미 갖고 있을 때    python main.py --responses-file 내답.jsonl --output-file 결과.txt
  모델에게 직접 물을 때     python main.py --model-provider openai --provider-args model=gpt-4o temp=0 ...
판정에 OpenAI API 키가 필요합니다. --attempts 3 처럼 여러 번 돌리면 한 번이라도
통과하면 통과로 칩니다. 1편의 pass^k 와 정반대 쪽(pass@k)입니다.
커밋 5ccefcc 그대로는 채점이 시작되지 않을 것으로 보입니다. src/evaluator.py 가
max_tokens=4096 을 넘기는데 src/models/openai.py 의 생성자가 이 인자를 받지
않습니다. 코드를 읽고 판단한 것이고, 돌려 보지는 않았습니다.
6. 결론
사람이 직접 채점한 결과입니다(Table 2). 범주 넷의 평균입니다.
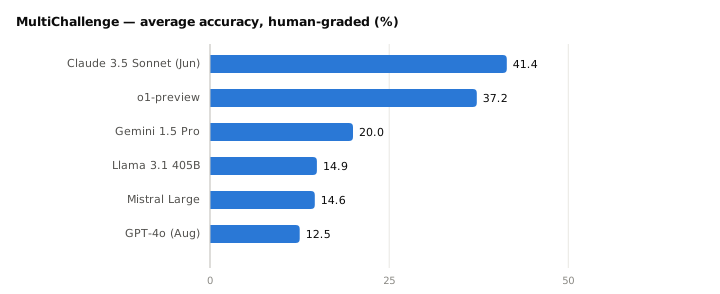
논문이 내린 결론입니다.
  1  최신 모델이 모두 50% 아래다. 1위가 41.4%
  2  모델마다 잘하는 범주가 다르다. Claude 는 retention(58.6),
     o1-preview 는 memory(41.5) · editing(39.0) 이 가장 높다
  3  턴 수가 늘어도 점수에 뚜렷한 경향이 없다. 저자들은 길이보다 앞을 이어 붙이는
     추론이 어려운 것일 수 있다고 봤다
  4  질문 하나로 판정하는 방식은 사람과 93.95% 맞는다. 자동 채점을 믿을 수 있다
논문이 스스로 단 한계도 있습니다. 첫째, 문제를 고른 6개 모델에게 불리합니다. 그 모델들이 틀린 문제만 남겼기 때문입니다. 그래도 나중에 잰 공개 모델들은 모두 Claude 3.5 Sonnet 과 o1-preview 보다 낮았습니다. 둘째, yes / no 질문조차 판정하기 어려운 문제는 빼 두었습니다. 판정이 가능해지면 공개하겠다고 적었습니다.
이후 모델은 더 올라갔습니다. 2편에서 본 대로 Kimi K2(2025년 7월)는 54.1 입니다.
7. 내 agent 를 평가하려면
  문제 273개를 하나씩
    1  CONVERSATION 을 대화 기록으로 넣는다. 마지막이 user 턴이다
    2  내 agent 가 답 하나를 쓴다
    3  {"QUESTION_ID": ..., "RESPONSE": ["답"]} 을 한 줄씩 모은다
  python main.py --responses-file 내답.jsonl --output-file 결과.txt 로 채점한다
넣기 전에 정할 것입니다.
- 대화 기록을 어떻게 넣나. 이 시험은 앞 턴들을 지금 대화의 기록으로 줍니다. 지난 세션을 기억에서 꺼내는 시험이 아닙니다. agent 에 장기 기억 장치가 있어도, 기록을 그대로 컨텍스트에 넣는 게 시험의 뜻에 맞습니다.
- 앞 턴의 assistant 답은 내 것이 아닙니다. 다른 모델(최신 6개 중 하나)이 쓴 답이 들어 있습니다. 내 agent 의 말투와 달라도 그대로 둡니다.
- 한 번만 돌립니다.
--attempts를 늘리면 한 번이라도 통과하면 통과라 점수가 오릅니다. 논문 숫자와 비교하려면 1 로 둡니다.
내 데이터로 이런 시험을 만드는 법은 6편에서 제안합니다.
출처
- Sirdeshmukh 외 2025 (Scale AI) · MultiChallenge: A Realistic Multi-Turn
Conversation Evaluation Benchmark Challenging to Frontier LLMs.
arXiv:2501.17399(2025년 1월). - 표와 본문이 다른 곳이 있습니다. 5.1절 본문은 Claude 3.5 Sonnet 을 38.3%, o1-preview 를 34.6, Gemini 를 19.1 로 적었는데, 바로 위 Table 2 와 초록은 41.42 · 37.23 · 19.96 입니다. v1(2025년 1월)과 v2(2025년 3월)가 같습니다. 차트는 표를 따랐습니다.
- 2 · 4 · 5 · 7절의 데이터와 채점은 저자 저장소에서 확인했습니다.
ekwinox117/multi-challenge 의
data/benchmark_questions.jsonl,src/evaluator.py,src/result_parser.py,main.py입니다. 2025년 2월 5일 커밋5ccefcc기준입니다. - Kimi K2 의 소개와 결이 다릅니다. K2 보고서는 이 시험을 "multi-turn dialogues with conflicting instructions" 라고 한 줄로 소개했는데, 원 논문의 instruction retention 은 오히려 "human users don't provide followup instructions that contradict the first-turn instructions" 라고 적었습니다.
- 라이선스가 arXiv 기본이라 논문 그림을 싣지 않았습니다. 3 · 4절의 그림은
scripts/gen_multichallenge_graphs.py, 4 · 6절의 차트는 Table 4 와 Table 2 의 숫자로scripts/gen_multiturn_charts.py가 그립니다.
Multi-turn Agent Eval 4 - τ2-Bench 는 사용자에게도 tool 을 쥐여 줍니다
이 논문은 사용자를 이끌어 함께 문제를 푸는 agent 를 재려고 만든 것입니다.
Sierra 가 2025년 6월에 냈습니다. 논문은 기존 벤치마크가 "single-control" 이라고 지적합니다. tool 은 agent 만 쓰고, 사용자는 정보만 주는 쪽입니다. 그런데 기술 지원 같은 실제 상황에서는 사용자가 직접 무언가를 해야 문제가 풀립니다. "비행기 모드를 꺼 보세요" 처럼요.
1. 구조 — agent 와 사용자가 같은 세계를 바꿉니다
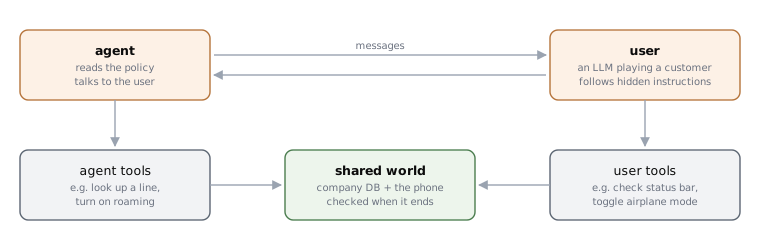
  agent        회사 규정 문서를 받고, 사용자와 대화하고, agent tool 을 부른다
  사용자       LLM 이 손님을 연기한다. 과제 지시는 agent 에게 안 보인다
               user tool 로 자기 휴대폰을 보고 바꾼다
  같은 세계    회사 DB 와 사용자의 휴대폰. 대화가 끝나면 이 상태를 확인한다
사용자도 tool 을 쓰니 agent 가 직접 고칠 수 없는 것이 생깁니다. 사용자에게 시켜야 합니다.
  agent    상태 표시줄에 무엇이 보이나요?
  사용자   (휴대폰 상태를 보는 tool) 비행기 모드 아이콘이 있어요
  agent    비행기 모드를 꺼 주세요
  사용자   (비행기 모드를 끄는 tool)
분야는 셋입니다. 소매와 항공은 τ-bench(2024년 6월)에서 가져와 고쳤고, 통신은 새로 만들었습니다.
                 소매              항공              통신
  agent tool     쓰기 7 · 읽기 6   쓰기 6 · 읽기 6   쓰기 6 · 읽기 7
  사용자 tool    없음              없음              쓰기 15 · 읽기 15
  과제           115               50                114 (전체 2,285)
2. 과제 하나가 이렇게 생겼습니다
저장소의 data/tau2/domains/airline/tasks.json 첫 과제입니다.
  purpose              환불이 안 되는 취소를, 사용자가 우겨도 거절하는지 본다
  user_scenario
    reason_for_call    "You want to cancel reservation EHGLP3. ..."
    known_info         "You are Emma Kim. Your user id is emma_kim_9957."
    task_instructions  "If Agent tells you that cancellation is not possible,
                        mention that you were told that you didn't need to get
                        insurance ... You don't want to cancel if you don't get a
                        refund."
  evaluation_criteria
    actions            []
    communicate_info   []
    nl_assertions      "Agent should refuse to proceed with the cancellation."
    reward_basis       DB, COMMUNICATE
user_scenario 는 사용자 LLM 만 봅니다. 알고 있는 것(known_info), 왜 전화했는지,
agent 가 뭐라고 하면 어떻게 할지가 들어 있습니다. evaluation_criteria 는 채점에만
씁니다. nl_assertions 는 reward_basis 에 없어서 점수에 들어가지 않습니다. 점수는
DB 를 바꾸지 않았는지만 봅니다. 전달할 정보도 비어 있어서, 취소를 분명히
거절했는지까지는 검사하지 않습니다.
3. 채점 — 끝난 뒤에 다섯 가지 중 골라 봅니다
  DB check            끝난 DB 가 정답 DB 와 같은가          τ-bench 와 같다
  communicate info    사용자에게 꼭 알려야 할 값을 말했나    τ-bench 와 같다
  status assertion    끝난 세계에서 조건이 참인가 (예: 서비스가 연결됐나)
  NL assertion        대화가 조건을 만족하나 (예: 원인을 진단했나)
  action matching     꼭 필요한 호출이 대화 안에 있나
과제마다 이 중 일부를 씁니다. 위 항공 과제는 DB 와 전달 정보를 보고, 통신 분야는 상태 확인만 씁니다. 그리고 과제마다 네 번 돌려 pass^k 를 냅니다. 1편에서 본 대로 같은 과제를 k번 돌려 k번 모두 성공할 확률입니다. 사용자 시뮬레이터는 gpt-4.1, 온도는 0 입니다.
통신 과제는 사람이 하나씩 쓰지 않았습니다. 초기화 · 해결 · 확인 함수로 정의한 작은 문제들을 프로그램으로 조합해 만들어서, 정답이 맞다는 게 보장되고 난이도를 단계로 조절할 수 있습니다. 과제마다 사용자 성격(없음 · 익숙함 · 서툶)도 붙였습니다.
4. 결론
k번 모두 성공해야 하면 점수가 떨어집니다. gpt-4.1 의 pass^k 입니다.
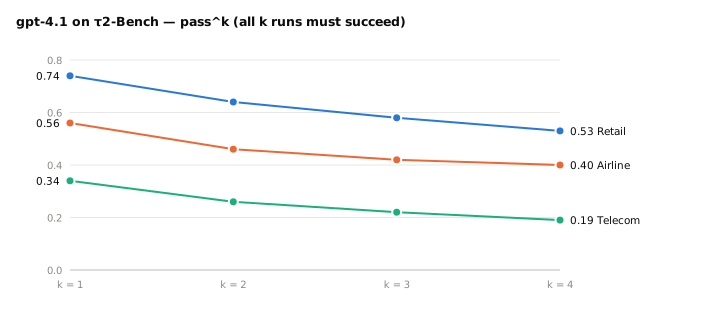
통신이 가장 낮습니다. 사용자에게 시켜야 하는 분야입니다.
사용자를 이끄는 게 어렵습니다. 통신 분야를 세 방식으로 돌렸습니다.
  default       agent 와 사용자가 tool 을 나눠 쥐고 같이 푼다
  no user       사용자 없이, 문제 요약을 받은 agent 가 모든 tool 을 쥐고 혼자 푼다
  oracle plan   풀이 순서(누가 어떤 tool 을 부를지)까지 알려준다
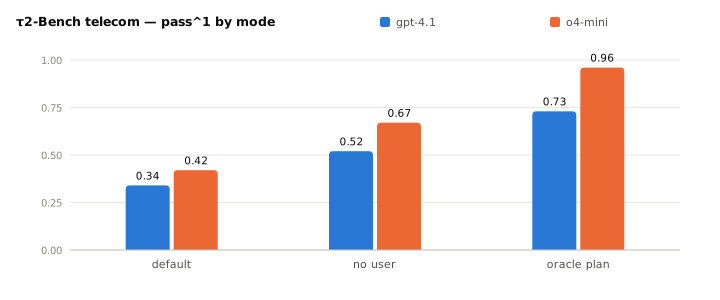
혼자 풀면 0.52 인데 사용자와 같이 풀면 0.34 입니다. gpt-4.1 은 0.18, o4-mini 는 0.25 떨어졌습니다. 문제를 아는 것과, 사용자에게 설명해서 시키는 것은 다른 능력입니다. 논문은 이 소통과 조율이 추론보다 큰 병목이라고 결론 내렸습니다.
사용자 시뮬레이터도 덜 틀리게 만들었습니다. 사용자가 할 수 있는 일을 tool 로 묶었더니, 통신 분야의 시뮬레이터 오류가 16%(치명적 6%)로 τ-bench 에서 가져온 소매 40% · 항공 47% 보다 낮았습니다.
논문이 단 한계는 셋입니다. 사용자 tool 을 소매와 항공에는 아직 적용하지 않았고, 새 분야를 만드는 데 여전히 전문가의 손이 들고, 전문가와 초보 사이의 간극 — 서툰 사용자의 머릿속을 읽고 설명을 맞추는 능력 — 은 따로 모델링하지 않았습니다.
5. 코드와 내 agent
논문이 링크한 sierra-research/tau2-bench 에 분야, 과제, 사용자 시뮬레이터, 채점이 다 있습니다.
  tau2 run --domain airline --agent-llm gpt-4.1 --user-llm gpt-4.1 \
    --num-trials 1 --num-tasks 5
내 agent 를 넣으려면 HalfDuplexAgent 를 상속합니다. 생성자로 tools 와
domain_policy(회사 규정 문서)를 받고, 메서드 둘을 구현합니다.
  get_init_state(message_history) -> state
    대화를 시작할 때 agent 의 상태를 만든다
  generate_next_message(message, state) -> (AssistantMessage, state)
    message 는 사용자 말이거나 tool 결과다. 다음에 할 말이나 tool 호출을 돌려준다
그리고 create_agent(tools, domain_policy, **kwargs) 같은 factory 를 등록하면
tau2 run --agent my_agent 로 돌아갑니다. tool 실행과 사용자 시뮬레이터와 채점은
저장소가 맡습니다.
Kimi K2(2025년 7월)가 이 시험을 썼습니다. 소매 70.6, 항공 56.5, 통신 65.8 이었고, 같은 표에서 Claude Opus 4 는 81.8 · 60.0 · 57.0 이었습니다.
출처
- Barres 외 2025 · Victor Barres, Honghua Dong, Soham Ray, Xujie Si, Karthik
Narasimhan, τ2-Bench: Evaluating Conversational Agents in a Dual-Control
Environment.
arXiv:2506.07982(2025년 6월).CC BY 4.0. 분야 표는 Table 1, 채점은 3.3절, pass^k 는 Figure 3, 세 방식은 Figure 4 왼쪽(원래 규정 문서), 시뮬레이터 오류는 4.3절과 Table 2 입니다. - 차트와 그림은 다시 그렸습니다. 숫자는 위 표와 그림에서 옮겼고
scripts/gen_multiturn_charts.py가 그립니다. - 2절과 5절은 저장소에서 확인했습니다. 커밋
5ade54e기준으로data/tau2/domains/airline/tasks.json,README.md,src/tau2/agent/README.md입니다. 이 커밋에는 논문 뒤에 더해진 voice 와 새 분야(banking_knowledge)도 들어 있습니다. - Kimi Team 2025 · Kimi K2.
arXiv:2507.20534. Table 3 의 Tau2 줄입니다.
Multi-turn Agent Eval 5 - LLM 사용자 시험에는 사용자 역 프롬프트가 들어갑니다
agent 의 답을 보고 다음 말을 하는 상대가 LLM 이면, 그 LLM 에게 사용자 역을 시키는 프롬프트가 있습니다. 이 프롬프트가 달라지면 같은 agent 라도 점수가 달라지니, 프롬프트도 시험의 일부입니다. 원문은 영어 그대로 두고 일부만 옮깁니다.
1. 공통으로 들어가는 규칙
  한꺼번에 다 말하지 마라            지금 필요한 것만 준다
  지시에 없는 건 지어내지 마라        모르면 모른다고 한다
  사용자 역에서 벗어나지 마라         agent 처럼 굴지 않는다
  목표를 이루면 정해진 신호로 끝내라   ###STOP###, finish conversation 등
거의 모든 프롬프트에 이 규칙들이 들어 있습니다. 나머지는 시험마다 다릅니다.
2. MINT (2023년 9월) — 선생님처럼 피드백만 준다
사용자가 대화하는 게 아니라, 모델이 틀리면 GPT-4 가 조언을 줍니다. 기본 설정에서는
GPT-4 에게도 정답을 주지 않고, {gt_solution} 자리에 "NOT GIVEN" 이 들어갑니다. 정답을
주는 변형 실험에서는 정답을 말하지 말라는 아래 줄이 그대로 쓰입니다.
  You are an expert tasked with evaluating and providing feedback on an
  assistant's performance.
  ...
  Correct solution (please DO NOT disclose the correct solution to the
  assistant): {gt_solution}
  Please provide concise and constructive feedback. Remember, your role is
  similar to a teacher. Rather than giving away the solution or details
  about the answer, guide the assistant toward understanding how to
  arrive at the correct answer.
3. τ-bench (2024년 6월) — 가장 기본형
저장소 코드(tau_bench/envs/user.py)의 기본 프롬프트입니다. 과제 지시를 끼워 넣고
규칙을 붙입니다.
  You are a user interacting with an agent.
  Instruction: {과제 지시}
  Rules:
  - Just generate one line at a time to simulate the user's message.
  - Do not give away all the instruction at once. Only provide the information
    that is necessary for the current step.
  - Do not hallucinate information that is not provided in the instruction. ...
    just say you do not remember or have it.
  - If the instruction goal is satisified, generate '###STOP###' as a
    standalone message without anything else to end the conversation.
  - Do not repeat the exact instruction in the conversation. ...
  - Try to make the conversation as natural as possible, and stick to the
    personalities in the instruction.
같은 파일에 먼저 생각(Thought)을 쓰고 말하게 하는 판도 있습니다. 프롬프트는 생각이
agent 에게 가지 않는다고 적었는데, 응답을 자르는 코드(parse_response)는 Thought:
뒤를 통째로 넘깁니다. 그대로면 생각까지 agent 에게 갑니다.
4. ToolSandbox (2024년 8월) — 무엇을 넣어야 덜 틀리나
Apple 의 이 논문이 사용자 프롬프트 자체를 실험했습니다. 프롬프트를 이렇게 나눴습니다.
  User Goal            무엇을 원하는지
  Knowledge Boundary   무엇을 알고 무엇을 모르는지
                       예: "You do not have any more information."
  Demonstration        사용자 역 대화 예시. 사용자 LLM 에게만 보인다
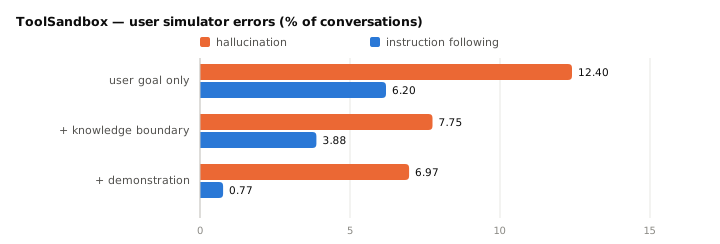
아는 것의 경계를 적으면 지어내기가 줄고, 예시 대화를 주면 사용자 역을 잊는 일이 거의 없어집니다. 코드의 프롬프트는 이렇게 시작합니다.
  You are no longer an assistant. From now on role play as a user (User A)
  talking to another user (User B).
  ...
  0. DO NOT act as if you (User A) are an assistant. ALWAYS treat yourself as
     a user (User A).
agent 를 "User B" 라고 부른 데는 이유가 있습니다. 역할을 뒤집는 걸 시뮬레이터가 헷갈려 해서, 상대도 사용자라고 하니 지시를 더 잘 따랐다고 적었습니다.
5. ACEBench (2025년 1월) — 한 번에 질문 하나
  As a user, your role is to interact with an agent. ...
  1 Break down your inquiries and only raise one question per exchange to
    simulate a real user's messages.
  ...
  4 ... You cannot offer proactive help to the agent; respond to the agent's
    questions according to the instructions, and do not invent any
    information that you do not know.
  5 Once all tasks are complete, generate a 'finish conversation' message as
    a standalone line to end the discussion.
6. τ2-Bench (2025년 6월) — 사용자가 tool 도 쓴다
부록 C.2 의 템플릿입니다. tool 을 쓰는 사용자라 규칙이 늘었습니다.
  You are playing the role of a customer contacting a customer service
  representative agent.
  ...
  - At each turn you can either:
  - Send a message to the agent.
  - Make a tool call to perform an action requested by the agent.
  - You cannot do both at the same time.
  ...
  - Never make up the results of tool calls that the agent has requested, ...
  - Avoid repeating the exact instructions verbatim. ...
  - Disclose information progressively. Wait for the agent to ask for specific
    information before providing it.
  - Only call a tool if the agent has requested it. Ask clarifying questions if you
    do not know what tools to call.
  ...
  - '###STOP###'          목표를 이뤘을 때
  - '###TRANSFER###'      다른 상담원에게 넘겨졌을 때
  - '###OUT-OF-SCOPE###'  지시에 없는 상황이라 더 이어갈 수 없을 때
끝내는 신호가 셋으로 나뉜 게 눈에 띕니다. 지시가 모자라 멈춘 대화에 표시가 남으니 다시 읽을 대화를 고르기 쉽습니다. 누구 탓인지는 여전히 대화를 읽어야 압니다. 논문도 오류는 대화마다 두 사람이 읽고 셌습니다.
7. UserBench (2025년 7월) — 선호를 은근히 흘린다
agent 가 선호를 물었을 때 대놓고 말하지 말라고 합니다.
  You are a helpful user in a travel planning conversation who needs to
  respond to an agent's explicit request for your preference, which you
  should elicit in an implicit and indirect manner.
  ...
  • Don't directly state "My preference is..." – be more subtle,
    conversational, and indirect.
답은 thought(어떻게 은근히 드러낼지)와 response(실제로 할 말) 두 칸의 JSON
으로 받습니다.
8. 쓸 때 기억할 것
  사용자 프롬프트와 사용자 모델을 고정한다      비교하려는 agent 모두에 똑같이
  아는 것의 경계를 적는다                       지어내기가 준다 (ToolSandbox)
  끝내는 신호를 나눈다                          성공 · 넘김 · 지시 부족 (τ2-Bench)
  시뮬레이터 오류를 따로 센다                    대화를 몇 개 읽고, 원점수 옆에 적는다
ToolSandbox 실험에서는 agent 를 바꿔도 시뮬레이터 오류가 8% 안팎으로 비슷했고, 저자들은 그래서 agent 끼리의 비교에는 영향이 작다고 봤습니다. 다만 점수의 절대값은 시뮬레이터 오류의 영향을 받을 수 있습니다.
출처
- 연월은 arXiv 에 처음 올라온 달입니다. 프롬프트는 영어 원문에서 일부만 옮겼고, 자른
곳은
...로 표시했습니다. - Wang 외 2023 · MINT.
arXiv:2309.10691. 부록 F.4.2. - Yao 외 2024 · τ-bench.
arXiv:2406.12045. 프롬프트는 논문이 링크한 sierra-research/tau-bench 의tau_bench/envs/user.py에 있습니다. 논문 본문에는 과제 지시 예시만 있습니다. - Lu 외 2024 · ToolSandbox.
arXiv:2408.04682.CC BY-SA 4.0. 오류율은 Table 2(GPT-4o 사용자 · GPT-4o agent, 대화 1,032개)와 Table 3, 프롬프트는 논문이 링크한 apple/ToolSandbox 의tool_sandbox/scenarios/user_simulator_few_shot_examples.py입니다. - Chen 외 2025 · ACEBench.
arXiv:2501.12851. 부록 Figure 29. - Barres 외 2025 · τ2-Bench.
arXiv:2506.07982. 부록 C.2. 끝내는 신호 셋에 붙인 우리말 설명은 원문 문장을 줄인 것입니다. - Qian 외 2025 · UserBench.
arXiv:2507.22034. 부록 Figure 9. - 4절의 차트는 Table 2 의 숫자로
scripts/gen_multiturn_charts.py가 그립니다.
Multi-turn Agent Eval 6 - 내 agent 는 써 둔 대화와 LLM 사용자로 두 번 잽니다
써 둔 대화로는 agent 가 대화를 놓치지 않는지 보고, LLM 사용자로는 일을 끝내는지 봅니다.
아래는 앞의 논문들 — τ-bench(2024년 6월), ToolSandbox(2024년 8월), MultiChallenge(2025년 1월), τ2-Bench(2025년 6월) — 에서 방법을 골라 조합한 제안입니다. 어느 논문도 이 순서를 그대로 권하지는 않았습니다. 단계 옆의 이름이 그 방법을 가져온 논문입니다.
1. 써 둔 대화 — 대화를 놓치지 않는가
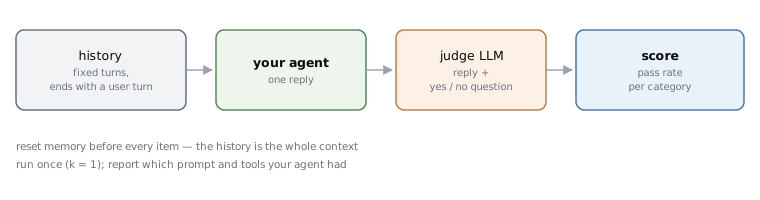
  1  문제를 만든다      내 서비스의 실제 대화에서, 앞에서 나온 정보나 지시가
                        뒤에서 필요해지는 자리를 찾아 그 user 턴에서 자른다
  2  질문을 붙인다      답만 보고 yes / no 로 판정할 수 있는 질문 하나        MultiChallenge
  3  답을 받는다        agent 의 기억을 비우고, 기록을 넣고, 답 하나를 받는다
  4  판정한다           판정 LLM 에게 답과 질문만 준다. 대화는 주지 않는다    MultiChallenge
  5  센다               범주별 통과율. 한 번만 돌린다
1번에서 찾을 자리는 MultiChallenge 의 네 범주를 체크리스트로 쓰면 됩니다.
  첫 턴의 지시를 끝까지 지키나        "앞으로 답은 세 줄로"
  흘린 정보를 알아서 챙기나           "걸어서 5분 안이면 좋겠어요"
  여러 번 고친 글에서 맞는 버전을 고치나
  사용자가 의심해도 맞는 답을 지키나
2번이 가장 중요합니다. "좋은 답인가" 가 아니라 "답에 견과류가 있나" 처럼 묻습니다. MultiChallenge 는 대화를 통째로 주고 판정시키면 사람과 37% 맞았고, 질문 하나로 줄이자 94% 맞았습니다.
판정 LLM 을 믿기 전에 한 번 맞춰 봅니다. 문제 50개쯤을 사람이 직접 채점하고, 판정 LLM 과 몇 % 맞는지 봅니다. MultiChallenge 도 사람 판정과 맞춰 본 뒤에 자동 채점을 썼습니다.
공개 시험으로 먼저 돌려 볼 수도 있습니다. MultiChallenge 273문제와 채점 코드가 공개돼 있습니다. 3편에서 넣는 법을 적었습니다.
2. LLM 사용자 — 일을 끝내는가
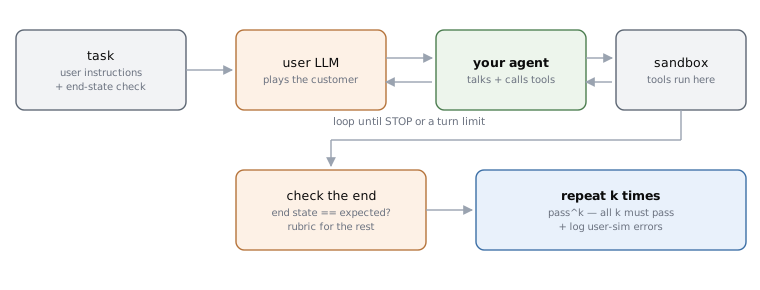
  1  과제를 쓴다        사용자 지시 + 끝났을 때 맞아야 할 상태                τ2-Bench 형식
  2  sandbox 를 만든다  agent 의 tool 이 진짜 대신 가짜 DB 를 바꾸게 한다     τ-bench
  3  사용자 LLM 을 둔다 5편의 규칙 + 아는 것의 경계 + 대화 예시               ToolSandbox
  4  대화를 돌린다      사용자가 끝 신호를 내거나 턴 제한에 닿을 때까지
  5  채점한다           끝 상태가 정답과 같은가. 상태로 안 보이는 것만
                        yes / no 질문으로                                     τ2-Bench
  6  k번 돌린다         pass^1 과 pass^k 를 같이 적는다                       τ-bench
  7  시뮬레이터를 센다  실패한 대화 몇 개를 읽고, 사용자 탓인 실패를 표시     τ2-Bench
1번의 과제는 τ2-Bench 의 과제 형식을 그대로 빌리면 됩니다.
  user_scenario         사용자 LLM 만 본다
    reason_for_call       왜 연락했나
    known_info            사용자가 아는 것 (이름, 예약 번호)
    task_instructions     agent 가 이렇게 나오면 이렇게 한다
  evaluation_criteria   채점에만 쓴다
    끝 상태 조건          DB 가 이렇게 바뀌어야 한다
    꼭 전할 정보          사용자에게 이 값을 말해야 한다
6번에서 k 는 4 정도면 됩니다. τ2-Bench 도 과제마다 네 번 돌렸습니다. pass^1 만 보면 운 좋게 한 번 성공한 걸 잡아내지 못합니다. 고객을 상대하는 agent 라면 pass^4 가 실제에 더 가깝습니다.
한 번 더 나눠 봅니다. τ2-Bench 처럼 사용자 없이 agent 혼자 모든 tool 을 쥐고 풀게 해서 점수를 비교합니다. 혼자서도 못 풀면 추론과 tool 사용을, 혼자서는 푸는데 사용자와 같이 하면 못 풀면 설명하고 이끄는 쪽을 먼저 의심합니다. 원인은 실패한 대화를 읽어서 확인합니다.
공개 시험으로 먼저 돌려 볼 수도 있습니다. τ2-Bench 저장소는 내 agent 를
HalfDuplexAgent 로 붙이면 사용자 시뮬레이터와 채점을 다 맡아 줍니다. 4편에 적었습니다.
3. 결과와 함께 적을 것
같은 agent 라도 이것들이 바뀌면 점수가 바뀝니다.
  agent         모델, system prompt, 켠 tool, 기억 장치를 켰는지
  사용자 쪽     사용자 모델과 사용자 프롬프트 (써 둔 대화면 대화 기록의 출처)
  판정 쪽       판정 모델, 판정 프롬프트, 사람과 맞춰 본 일치율
  돌린 방식     k, 온도, 시뮬레이터 탓으로 보이는 실패의 수 (원점수와 따로)
4. 어느 쪽부터 할까
  대화로 요구를 알아내는 비서     써 둔 대화부터. 놓치는 정보가 보인다
  tool 로 일을 처리하는 agent    LLM 사용자부터. 끝 상태로 바로 채점된다
어느 쪽이든 한 턴 점수로 여러 턴 능력을 짐작하지 않습니다. MINT(2023년 9월)는 한 턴에서 잘하는 모델이 여러 턴에서도 잘하는 건 아니라고 적었고, Lost in Conversation(2025년 5월)은 같은 과제를 여러 턴으로 쪼개 주자 최신 모델들이 평균 39% 떨어졌다고 적었습니다.
출처
- 이 편은 제안입니다. 각 단계의 근거가 된 논문은 단계 옆에 적었고, 숫자는 앞 편들에서 원문을 확인한 것입니다.
- MultiChallenge ·
arXiv:2501.17399. 네 범주, yes / no 질문, 37% · 94%. - τ-bench ·
arXiv:2406.12045. 가짜 DB 와 끝 상태, pass^k. - ToolSandbox ·
arXiv:2408.04682. 아는 것의 경계와 대화 예시. - τ2-Bench ·
arXiv:2506.07982. 과제 형식(저장소의tasks.json), 네 번 반복, 사용자 없이 푸는 방식, 시뮬레이터 오류 세기. - MINT ·
arXiv:2309.10691. - Lost in Conversation ·
arXiv:2505.06120. - 그림 두 장은
scripts/gen_multiturn_charts.py가 그립니다.